NavRL 阅读笔记:动态环境下的无人机强化学习局部导航
论文:NavRL: Learning Safe Flight in Dynamic Environments
期刊:IEEE RA-L 2025
作者:Zhefan Xu, Xinming Han, Haoyu Shen, Hanyu Jin, Kenji Shimada
代码:https://github.com/Zhefan-Xu/NavRL
NavRL 研究的是无人机在动态环境中的局部导航:一边朝目标飞,一边躲开静态障碍和移动的行人。它的做法分三步:先把感知结果整理成几何化的状态,再用 PPO 训练一个输出速度的策略,最后用基于速度障碍(Velocity Obstacle)的安全层修正危险动作。整套系统在 Jetson Orin NX 上实时运行,并且从仿真零样本迁移到了真机。
这篇论文与“动态未知环境中的强化学习局部导航与真机部署”这个方向几乎完全重合:动态障碍感知、RL 决策、安全兜底、机载部署,这条链路它已经完整走了一遍。它的长处可以直接借鉴,短处也正好是后续最容易切入的地方。
一、要解决什么问题
传统局部规划通常拆成障碍预测、建图、轨迹优化等多个模块,参数多,换一个环境往往就要重新调。学习方法的适应性更好,但如果直接把图像作为输入,仿真和真实画面差别很大,很难迁移;而且神经网络一旦出错没有兜底,不敢直接上真机。
NavRL 想同时解决这几件事:训练一个能躲静态和动态障碍的局部策略,让它能稳定地迁移到真实无人机上,并在策略失误时有一个足够轻量的安全机制。
二、方法
整体流程如下。静态障碍和动态障碍分成两条支路处理,汇合后送入策略网络:
| 环节 | 具体做法 | 作用 |
|---|---|---|
| 静态障碍建模 | occupancy voxel map + 3D ray casting | 把复杂的静态环境压缩成局部可通行性表示 |
| 动态障碍建模 | 检测、分类、跟踪、测速 | 显式保留动态目标的位置、速度和尺寸 |
| 策略学习 | PPO + actor-critic + Beta 动作分布 | 学习目标驱动的局部速度控制 |
| 安全修正 | VO-inspired action projection | 对网络失误做轻量的几何纠偏 |
| 大规模训练 | Isaac Sim 并行训练 1024 架四旋翼 | 加快收敛,增加数据多样性 |
1. 静态障碍:用射线距离代替整张地图
作者先用深度图在线构建三维占据体素地图,但并不把整张地图送进网络,而是从无人机当前位置向各个方向做射线投射(ray casting),记录每个方向离障碍有多远,得到一个二维距离矩阵。
网络看到的是“哪些方向空、哪些方向堵”,而不是图像纹理或稀疏的体素。输入维度小了,仿真和真实环境之间的差异也小了。
2. 动态障碍:单独检测和跟踪
会动的障碍不进体素地图,而是单独处理:用 U-depth detector 和 DBSCAN detector 检测,YOLO 分类,Kalman filter 跟踪,最后得到每个动态障碍的相对位置、距离、速度和尺寸。
这样策略不仅知道前面有东西,还知道它往哪儿动、动多快。需要说明的是,这部分检测与跟踪主要沿用作者之前的工作,不是本文的核心贡献,但对真机部署非常重要。
3. 策略网络:PPO 输出有界速度
静态距离矩阵和动态障碍矩阵分别经过 CNN 提取特征,再与无人机自身状态拼接,送入 actor-critic 网络,用 PPO 训练。
这里有三处设计值得注意:
- 静态障碍和动态障碍走两条独立支路;
- 所有量都表示在目标坐标系(goal coordinate frame)下;
- 动作是有上下限的速度指令,用 Beta 分布参数化,而不是姿态、电机转速或离散动作。
4. 安全层:把危险速度投影到安全区域
网络输出一个候选速度 。如果它不落在任何速度障碍区域内,就直接执行;如果会导致碰撞,就求解一个小规模的线性约束优化,找到离 最近的安全速度。
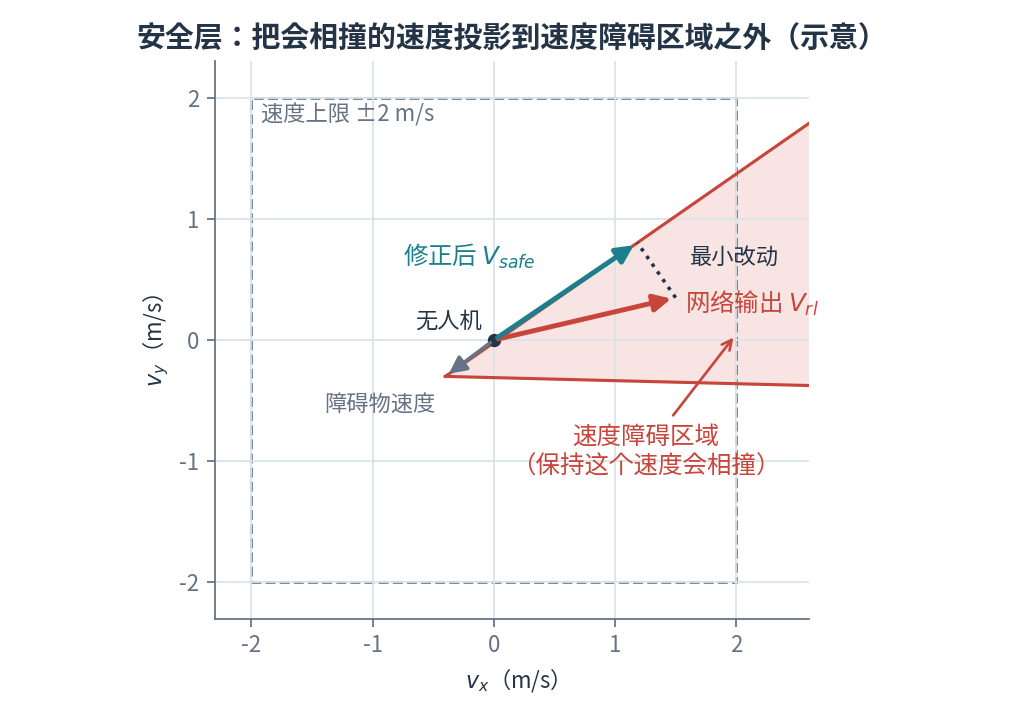
图中红色锥形区域是速度障碍:只要无人机保持这个区域内的速度,就会在一段时间内撞上障碍物。网络输出的 恰好落在里面,安全层把它挪到锥形边界上离它最近的点,改动尽量小。
策略负责飞得好,安全层负责不出事。真机系统一般不敢把最终控制权完全交给神经网络,这种串联结构很实用。
5. 哪些算是真正的创新
严格来说,这篇论文的创新在系统层面,理论上的新东西不多:
- 面向仿真到真机迁移的状态表示:静态射线距离 + 动态目标状态;
- 目标坐标系下的有界速度动作,用 Beta 分布处理连续有界动作;
- 基于速度障碍的安全投影,降低黑盒策略失误带来的碰撞风险;
- 用 Isaac Sim 同时训练上千架四旋翼,并完成零样本真机部署。
PPO、CNN 编码器和 Kalman 跟踪本身都是现成的方法。
三、关键公式
论文的公式不多,重点是弄清每个公式在系统里负责什么。
| 公式 / 对象 | 在系统里的作用 | 需要理解的点 |
|---|---|---|
| MDP 目标公式 (1) | 定义 RL 的总体优化目标 | 这是逐时刻的局部决策,不是整条轨迹优化 |
| 内部状态 (2) | 告诉策略“目标在哪、自己怎么动” | 用 goal frame 降低坐标系依赖,提升迁移性 |
| 动态障碍状态 (3)(4) | 显式描述最近的动态目标 | 关键是知道障碍怎么动 |
| 静态障碍状态 (5) | 用射线长度编码局部几何 | 把地图变成局部可通行性表示 |
| 动作公式 (6) | 输出有界连续速度 | 速度比低层控制更适合 sim-to-real |
| 奖励公式 (7)-(12) | 平衡前进、安全、平滑、高度约束 | 防止只会躲障碍不前进,或靠乱飞取巧 |
| 安全屏蔽公式 (13) | 把危险动作投影到安全区域 | 尽量少改 RL 动作,但不能撞上去 |
1. 优化目标
论文把问题写成标准 MDP,目标是最大化累计折扣回报:
网络不生成整条轨迹,而是每个时刻根据当前感知状态输出一个速度,属于反应式的局部决策。
2. 状态
无人机自身状态:
到目标的相对位置被拆成方向和距离,网络不必自己从坐标差里学方向归一化,训练更稳定。这些量都在目标坐标系下表示,弱化了绝对世界坐标的影响,策略学到的更接近“朝目标前进时如何避障”这种通用技能。
动态障碍状态:
每个动态障碍是一组带运动属性的对象,而不是一堆像素。对动态局部导航来说,知道障碍怎么动,往往比看到障碍更重要。
静态障碍状态:
每个 是一组射线长度,表示不同方向上与静态障碍的距离,相当于一张稠密的局部可通行性描述。
3. 动作
网络先输出归一化速度,再线性映射到最大速度范围内:
输出的是有明确边界的速度,而且在目标坐标系下;网络参数化的是 Beta 分布,天然适合有界连续动作。这样的动作既好学,也容易跨平台迁移,人也方便理解和监督。
4. 奖励
| 奖励项 | 形式 | 鼓励什么 |
|---|---|---|
| 目标方向单位向量 · 当前速度 | 沿目标方向快速前进 | |
| 平均 log(射线距离) | 远离静态障碍 | |
| 平均 log(与动态障碍的距离) | 与移动障碍保持间距 | |
| 速度变化平滑 | ||
| 惩罚过度上升 | 不靠往高处飞来避障 |
两个安全项用 log 而不是线性距离:离障碍很近时惩罚变化剧烈,离得足够远后再远一点收益就很小。平滑项在真机上很重要,没有它,RL 很容易学出“能躲,但飞得很抖”的控制。
最后一项很实用:很多 RL 策略确实会钻“飞高一点就没有障碍”这种空子。
5. 安全投影
尽量少改网络的动作;只有当网络动作会导致碰撞时,才把它推到最近的安全速度上。
四、实验
| 项目 | 内容 |
|---|---|
| 训练平台 | NVIDIA Isaac Sim,RTX 4090,约 10 小时,并行训练 1024 架四旋翼 |
| 仿真测试 | Gazebo,包含走廊场景以及高密度静态 / 动态 / 混合障碍环境 |
| 真机平台 | 自定义四旋翼 + Jetson Orin NX + Intel RealSense D435i + LIO |
| 对比方法 | EGO-Planner、ViGO、去掉安全层的 NavRL |
| 核心指标 | 训练成功率、训练回报、平均碰撞次数、各模块时延 |
ViGO 是作者之前做的 vision-aided dynamic planner。训练成功率指从起点无碰撞到达目标的比例,平均碰撞次数统计 20 次运行。
1. 课程学习明显提高成功率
训练环境为 50 m × 50 m,动态障碍数量按 60 → 80 → 100 → 120 逐步增加。在相同训练时间下:
| 动态障碍数量 | 不用课程学习 | 使用课程学习 |
|---|---|---|
| 80 | 74.51% | 82.71% |
| 100 | 62.30% | 80.96% |
| 120 | 54.98% | 68.65% |
动态障碍越多,课程学习带来的提升越大。对动态障碍局部导航来说,它是训练能否稳定的重要条件。
作者还比较了不同并行机器人数量下的训练回报:机器人越多,收敛越快,最终回报也越高。如果后续也用 Isaac Sim 或 OmniDrones 做大规模并行训练,训练吞吐量很可能决定动态交互策略能不能学出来。
2. 优势集中在动态和混合环境
在 20 m × 40 m 的高密度测试地图上,平均碰撞次数如下(— 表示笔记中没有记录该项):
| 环境 | EGO-Planner | ViGO | NavRL(无安全层) | NavRL |
|---|---|---|---|---|
| 静态 | 0.45 | 0.80 | 0.95 | 0.65 |
| 纯动态 | — | 3.15 | 2.70 | 0.85 |
| 混合 | — | 4.40 | 4.60 | 2.10 |
从这张表可以读出两点:
- 在静态环境里,NavRL 并不比 EGO-Planner 好(0.65 对 0.45)。它的价值在于动态和混合场景:纯动态环境的碰撞从 ViGO 的 3.15 降到 0.85,混合环境从 4.40 降到 2.10。
- 去掉安全层后,纯动态环境的碰撞从 0.85 升到 2.70,混合环境从 2.10 升到 4.60。只靠 RL 策略本身还不够稳,安全层在动态环境里几乎是决定性的组件。
3. 机载时延
Jetson Orin NX 上各模块的运行时间:
| 模块 | 时延 |
|---|---|
| 静态感知 | 15 ms |
| 动态感知 | 27 ms |
| RL 策略 | 7 ms |
| 安全层 | 16 ms |
合计约 65 ms,对应约 15 Hz,可以实时运行。瓶颈不在策略网络,而在前端感知和安全层。
4. 真机实验
作者在室内布置静态障碍,并让行人朝无人机走来。无人机零样本从仿真迁移到真实平台,在有行人干扰的情况下安全到达了目标。
5. 实验够不够充分
这些实验足以说明“这是一个可部署、在动态环境中有效的 RL 局部导航系统”,但不足以说明“这是动态无人机导航的通用最优方案”:
- 对比方法不够丰富,缺少更强的 RL 方法和混合方法;
- 真机实验证明了可行性,但规模有限;
- 主要指标是碰撞次数,缺少效率、舒适性、死锁率、TTC 裕度等更细的分析;
- 最大速度只有 2.0 m/s,偏安全导航,不是高速敏捷飞行。
五、局限
| 局限 | 原因 | 可能失败的场景 | 怎样验证 |
|---|---|---|---|
| 依赖前端感知质量 | 策略直接依赖动态障碍的检测、关联与速度估计 | 多人交错、遮挡、低光、深度噪声大、目标突然加速 | 做漏检率、测速噪声、感知时延的消融 |
| 动态障碍模型过于简化 | 障碍被抽象成 bounding box / sphere,用局部几何近似 | 非刚体目标、人群交互、急转弯目标、多障碍博弈 | 构造不同运动模型的场景,统计安全层触发率与碰撞率 |
| 安全层偏保守 | 只做局部动作投影,不理解长期通行结构 | 密集人群、窄门会车、短时堵塞 | 统计死锁率、等待时间、到达时间 |
| 状态表示丢失部分信息 | 射线图和对象级状态高效,但丢掉了纹理、语义和细几何 | 复杂立体场景、细长障碍、语义约束强的环境 | 与更丰富的地图或语义状态做消融 |
| 实验覆盖面有限 | 论文重点是先证明能飞、能避障、能上机 | 室外强光、大场景长航程、高速飞行、密集近距离交互 | 扩展到更复杂的真实环境和长期测试 |
其中影响最大的是第一条:真机部署时,这套系统的上限主要由前端感知和安全层共同决定,而不是策略学不学得会。
六、可以继续做的方向
围绕这篇论文继续做研究,应优先选择能解决部署问题、并且能用实验验证的方向,而不是只换一个网络结构。
| 方向 | 针对的不足 | 思路 | 难度 |
|---|---|---|---|
| 考虑感知不确定性的安全层 | 安全层默认感知可信,但真实的检测和测速都有噪声 | 把检测框、速度估计和跟踪协方差引入 VO 约束,做 risk-aware / chance-constrained shield | 中等偏高 |
| 对遮挡和短时丢失鲁棒的记忆策略 | 目标被遮挡后重新出现时,当前策略未必稳 | 加入 track history、短时记忆或显式意图预测 | 中等 |
| RL + 短时规划的混合框架 | 反应式策略加安全层在密集动态环境中可能过于保守,甚至卡住 | RL 给出局部意图,再由 MPC、采样或轨迹优化生成短时可执行轨迹 | 高 |
| 面向真机的鲁棒训练 | 论文证明了能迁移,但对迁移边界分析不足 | 把真实日志中的噪声、时延、漏检、模糊加入训练,做多种随机化 | 中等 |
| 人类意图建模 | 目前只处理“障碍在动”,没有建模“障碍想怎么动” | 引入行人意图预测和 social navigation 约束 | 高,且需要系统的人机交互实验 |
较推荐的组合是:感知不确定性建模 + 安全层升级 + 面向真机的鲁棒训练。这条线直接针对 NavRL 最薄弱的地方,也最容易形成“动态未知环境 + 真机部署”的完整论文故事。
七、总体评价
只看算法新颖性,NavRL 并不出众;但从“系统能不能真正落地”来看,它很有价值。它回答的问题是:RL 能不能和感知、安全机制、机载计算一起,组成一个真的能飞的动态导航系统。
这篇论文值得读,也值得复现,更值得在它暴露出来的问题上继续往前推。复现时建议优先关注这几个模块:状态表示的构造、射线投射的静态编码、动态目标跟踪接口、奖励函数实现、VO 安全层、Isaac Sim 并行训练配置,以及 PX4 / Jetson 的部署链路。