给定矩阵 A 和向量 b,求解 Ax=b,实际需要回答的是:矩阵有什么结构,应该用什么方法,以及算出的结果是否可信。
本文重点掌握 LU、Cholesky、QR 的用途,以及残差和条件数的区别。SVD 先理解“不同方向被放大或压缩多少”,伪逆放在文末按需查阅。列空间、零空间、内积和正定性沿用线性代数中的定义。
1. 先看问题结构,再选求解方法
对 A∈Rm×n,先区分三个问题:
- 精确求解:要求 Ax=b。可逆方阵对任意 b 都有唯一解。
- 最小二乘:不能精确满足所有方程时,寻找使 ∥Ax−b∥22 最小的 x。
- 多个解之间的选择:如果存在零空间,可能还需要最小范数等附加标准。
方程多于未知数并不必然无解,方程少也不保证可行;是否有精确解,仍取决于 b 是否在 A 的列空间中。
下面这张表是全文的使用入口,后面解释它为什么成立。
| 问题结构 |
常用方法 |
需要注意的条件 |
| 一般非奇异方阵 |
带选主元的 LU |
不必对称或正定 |
| 实对称正定矩阵 |
Cholesky |
只有对称性还不够 |
| 过定、满列秩最小二乘 |
QR |
避免先形成 A⊤A |
| 秩亏或接近秩亏 |
SVD 或带列选主元的 QR |
需要关注数值秩与阈值 |
| 对称不定系统 |
带适当选主元的 LDL⊤ 等方法 |
不能直接按正定系统处理 |
| 大规模稀疏或带状系统 |
对应的稀疏、带状求解器 |
通常还要结合上述结构选择 |
其中 LDL⊤ 只需先知道适用场景,具体分解过程可以在遇到相应求解器时再读。
2. LU:把一次消元保存下来
为什么先变成三角矩阵?
上三角系统可以从最后一行向上求,这叫 回代:
[2011][x1x2]=[31].
先得到 x2=1,再由 2x1+x2=3 得到 x1=1。下三角系统则从第一行向下求,称为 前代。这里都要求所用对角元素非零。
高斯消元的目的,就是把一般方程变成这种容易逐项求解的形式。例如:
{2x1+x2=3,4x1+3x2=7.
第二行减去第一行的 2 倍,得到 x2=1。系数矩阵恰好可以写成:
A=[2413]=L[1201]U[2011].
U 保存消元结果,L 保存消元倍数。于是原问题变成:
Ly=b,Ux=y.
先前代,再回代,就得到 x。
为什么还要选主元?
消元时用作除数的元素叫 主元。如果它是 10−6,下面待消去的元素是 1,消元倍数就会达到 106,更容易放大舍入误差。
部分选主元会在当前列的剩余行中寻找绝对值最大的元素,再交换到主元位置。因此常见形式是:
PA=LU,Ly=Pb,Ux=y.
P 记录行交换;右端项也必须跟着交换。理解“交换方程顺序后再消元”即可,不必手写置换矩阵。
为什么不先求逆?
虽然数学上 x=A−1b,但构造整个逆矩阵通常比求一个解做了更多工作,也增加了不必要的计算和舍入环节。
如果 A 不变,只是 b 改变,可以复用同一次分解:
Ax(1)=b(1),Ax(2)=b(2).
分解一次,随后重复求解三角系统,是比“每次重新求逆”更有用的计算习惯。
3. Cholesky:利用对称正定结构
对于实对称正定矩阵,可以写成:
A=LL⊤,
其中 L 为下三角矩阵;要求对角线为正时,分解唯一。
例如:
[4223]=[2102][2012].
从二次型看,它相当于把代价配成平方和:
4x12+4x1x2+3x22=(2x1+x2)2+2x22=∥L⊤x∥22.
求解时仍然分两步:
Ly=b,L⊤x=y.
由于上下两个三角部分互为转置,Cholesky 比一般 LU 更省计算与存储。
需要区分 对称、半正定、正定。例如 diag(1,0) 虽然半正定,却有平坦方向,不能保证普通 Cholesky 所需的正对角因子和唯一解。若分解失败,应先检查矩阵是否满足条件、是否接近奇异,以及尺度是否失衡。
4. 最小二乘与 QR:在列空间中找最近的点
最小二乘在解决什么?
假设一个未知数 x 同时被要求等于 1、2、3:
A=111,b=123.
三个方程不能同时满足,可以改为:
xmin (x−1)2+(x−2)2+(x−3)2.
最优解为 x=2,此时 Ax=(2,2,2)⊤ 是列空间中离 b 最近的点,残差 r=b−Ax=(−1,0,1)⊤ 与列向量正交。
一般情况下,最优残差满足:
A⊤(b−Ax)=0⟹A⊤Ax=A⊤b.
这称为 正规方程。它解释了最优条件,但并不意味着数值实现必须先构造 A⊤A。
QR 怎样求解?
当 m≥n 且 A 满列秩时,简化 QR 分解为:
A=QR,Q∈Rm×n,Q⊤Q=I,R∈Rn×n.
Q 的列是张成原列空间的一组单位正交方向,R 是上三角矩阵,记录原列向量在新方向下的坐标。
把 b 分成列空间内的投影和垂直于列空间的部分:
b=QQ⊤b+(I−QQ⊤)b.
两部分正交,因此:
∥QRx−b∥22=∥Rx−Q⊤b∥22+∥(I−QQ⊤)b∥22.
第二项不随 x 改变;令第一项为零,就得到:
Rx=Q⊤b.
最终只需回代。这也说明为什么正交方向有用:各方向互不干扰,长度与平方误差都容易计算。
在前面的例子里,Q=(1,1,1)⊤/3,R=3,因此 3x=6/3,仍得到 x=2。
为什么通常优先考虑 QR?
对满列秩矩阵,二范数条件数满足:
κ2(A⊤A)=κ2(A)2.
条件数描述问题对扰动的敏感程度,下一节会用例子解释。这个公式意味着:如果 A 已经接近秩亏,形成 A⊤A 会进一步恶化条件数。
QR 避免了这一步。实际库通常用 Householder 等方法实现;首次学习能解释分解的几何意义、适用条件和求解步骤即可。
5. SVD 与条件数:哪些方向容易丢失信息?
一个变换可以拆成换坐标、缩放、再换坐标
任意实矩阵 A∈Rm×n 都有奇异值分解:
A=UΣV⊤.
完整形式中,U 是 m×m 正交矩阵,V 是 n×n 正交矩阵,Σ 为 m×n 对角形矩阵,非负对角元素是奇异值。
对相应的列向量,最关键的关系是:
Avi=σiui,i=1,…,min(m,n).
沿输入方向 vi 的单位向量,经过变换后指向 ui,长度变成 σi。零奇异值表示某个方向被完全压扁;很小的奇异值表示某个方向几乎被压扁。
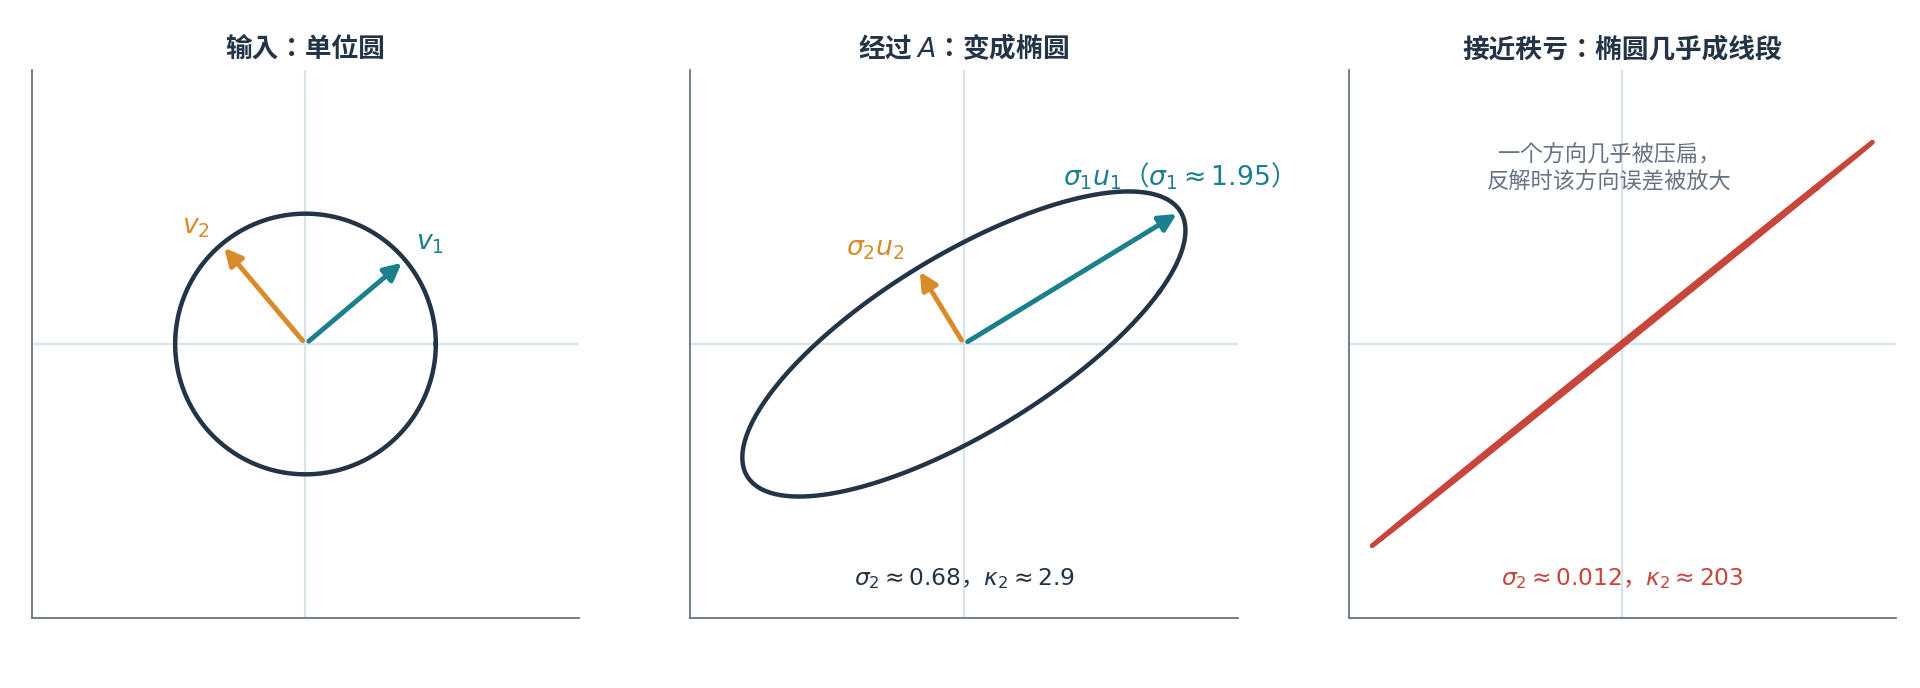
矩阵的秩等于非零奇异值的个数。实际浮点计算中,需要根据尺度和阈值判断“多小可以视为零”,不能简单用 sigma == 0 判断数值秩。
条件数为什么是最大、最小缩放的比值?
对可逆方阵,或采用奇异值比定义的满列秩矩阵:
κ2(A)=σminσmax.
不同方向的缩放越悬殊,反向恢复输入时就越容易放大某些方向上的误差。
例如:
A=[10010−6],b=[110−6],x=[11].
如果 b 的第二项增加 10−6,解的第二项就从 1 变成 2。右端项整体只受到很小的扰动,解却明显改变。这里 κ2(A)=106。
条件数大是问题本身敏感,算法不稳定是计算过程额外放大误差。稳定的求解方法能减少额外误差,但不能消除原问题的敏感性。SVD 能帮助看清这些方向,也不意味着它能凭空恢复已经缺失的信息。
6. 算完之后,怎样判断结果?
设计算结果为 x^,先代回原方程检查残差:
r=b−Ax^.
残差表示方程还差多少;解误差则是 e=x^−x,其中 x 为原方程的真实解。如果 A 可逆:
Ae=−r,e=−A−1r.
因此 残差小,不自动意味着解误差小。上节例子中的 x^=(1,2)⊤ 对原来的 b 只有 10−6 的残差,但第二个变量已错了 1。
还要结合尺度看残差。对非零分母,可使用:
∥A∥2∥x^∥2+∥b∥2∥b−Ax^∥2.
这比孤立地报告“残差小于某个绝对数”更容易比较不同量级的问题。
对于最小二乘,残差本来就可能不为零,应检查是否确实最小,例如观察一阶条件 A⊤(Ax^−b)≈0;对于秩亏问题,还要确认求解器返回的是哪一种解。
7. 实际计算中的结构与尺度
同一个矩阵,可以重复利用
多个右端项共享相同的 A 时,复用分解。若只是稀疏位置不变、数值已经改变,可能复用排序等结构分析,但一般不能直接复用原来的数值因子。
例如多项式系数由 A(T)c=b 决定:只改变右端边界值时,可以复用因子;改变时间 T 后,通常需要更新数值分解。
相邻变量耦合,会形成稀疏或带状矩阵
若每段只与邻段存在连续性关系,非零元素往往集中在主对角线附近,形成带状结构:
∗∗00∗∗∗00∗∗∗00∗∗.
应使用能保留这种结构的存储与求解方式。消元可能让原本为零的位置出现非零值,称为 填充;因此变量顺序和排序方式会影响计算成本。
多项式中的时间幂会改变数值尺度
对三次多项式 p(t)=c0+c1t+c2t2+c3t3,位置、速度边界条件可以写为:
101001T100T22T00T33T2c0c1c2c3=p(0)p˙(0)p(T)p˙(T),T>0.
当 T 很大或很小时,不同幂次可能相差很多数量级。时间归一化 s=t/T 和合适的变量尺度有助于改善这一问题,但速度、加速度条件也必须按链式法则同步换算,不能只替换矩阵中的时间数字。
带约束的系统不一定正定
二次目标和线性等式约束可能导出:
[QAA⊤0][xλ]=[−cb].
这称为 KKT 系统。即使 Q≻0,有非零约束时这个整体矩阵也不能按正定矩阵处理。先识别完整系统的结构,再决定使用哪种分解;KKT 的推导可以在学习约束优化时展开。
补充:伪逆与最小范数解
遇到秩亏或欠定系统时,再读这一部分即可。
SVD 定义 Moore–Penrose 伪逆:
A†=VΣ†U⊤,x†=A†b.
Σ† 的尺寸为 n×m,对非零奇异值取倒数,零奇异值仍置零。它给出所有最小二乘解中二范数最小的那个;若精确解存在,就得到最小范数精确解。
例如 x1+x2=2 有无穷多个解,其中范数最小的是 (1,1)⊤,而不是 (2,0)⊤。
很小的奇异值取倒数会放大噪声。截断小奇异值或加入正则化可以限制这种放大,但也改变了求解目标或保留的信息,需要结合数据尺度决定。
首次阅读能根据第 1 节选择方法、解释一次三角求解,并区分残差与条件数,就可以继续学习优化算法。Householder 的实现、稀疏排序、迭代法和预条件可等到具体求解器需要时再深入。