路径规划里的不确定性无处不在:GPS 和传感器的读数每次都不一样,障碍物位置只是估计值,RRT 靠随机采样扩展,采样式算法的理论保证也只是“采样越多,找到解的概率越大”。描述这些问题需要概率论,但入门阶段只需要掌握一条主线:
一、概率、样本空间与事件
概率描述某件事发生的可能性,记作 P(A),其中 A 是一个事件。它满足
0≤P(A)≤1,
P(A)=0 表示几乎不可能发生,P(A)=1 表示必然发生。例如抛一枚均匀硬币,A={出现正面},则 P(A)=0.5。
描述概率需要三个基本概念:
| 概念 |
含义 |
例子 |
| 随机试验 |
可以重复,但单次结果无法提前确定 |
测量静止无人机的位置,GPS 依次读到 10.02、9.98、10.01 m |
| 样本空间 Ω |
所有可能结果组成的集合 |
抛硬币 Ω={正,反};骰子 Ω={1,…,6} |
| 事件 |
样本空间中关心的那部分结果 |
骰子掷出偶数:A={2,4,6} |
测量连续位置时 x∈R,样本空间有无穷多个结果。
二、条件概率与独立性
条件概率 P(A∣B) 表示已知 B 发生后,A 发生的概率:
P(A∣B)=P(B)P(A∩B),P(B)>0.
直观地说,条件概率就是用新信息缩小讨论范围,再重新计算概率。例如一个班有 100 名学生,其中男生 60 人、女生 40 人,戴眼镜的男生 12 人。随机选一人:
P(戴眼镜且男生)=10012.
如果已知选中的是男生,范围就缩小到 60 人:
P(戴眼镜∣男生)=6012.
两个事件互不影响时称为独立,此时
P(A∩B)=P(A)P(B).
例如连续抛两次硬币,第一次的结果不影响第二次,两次都是正面的概率为 21×21=41。
三、随机变量与概率密度
随机变量可以理解为带有不确定性的数字,通常用大写字母 X,Y,Z 表示。例如令 X 为 GPS 测得的无人机 x 坐标,一次测量可能是 X=10.01,下一次可能是 X=9.97。它不是一个确定的数,每次试验都可能取不同的值。
随机变量分为两类:
- 离散随机变量的取值可以逐个列出,例如骰子 X∈{1,2,3,4,5,6},可以直接讨论 P(X=1)、P(X=2) 等;
- 连续随机变量的取值连续,例如位置、速度、距离,X∈R。此时单点概率没有意义,关心的是区间概率,例如 P(9.9<X<10.1)。
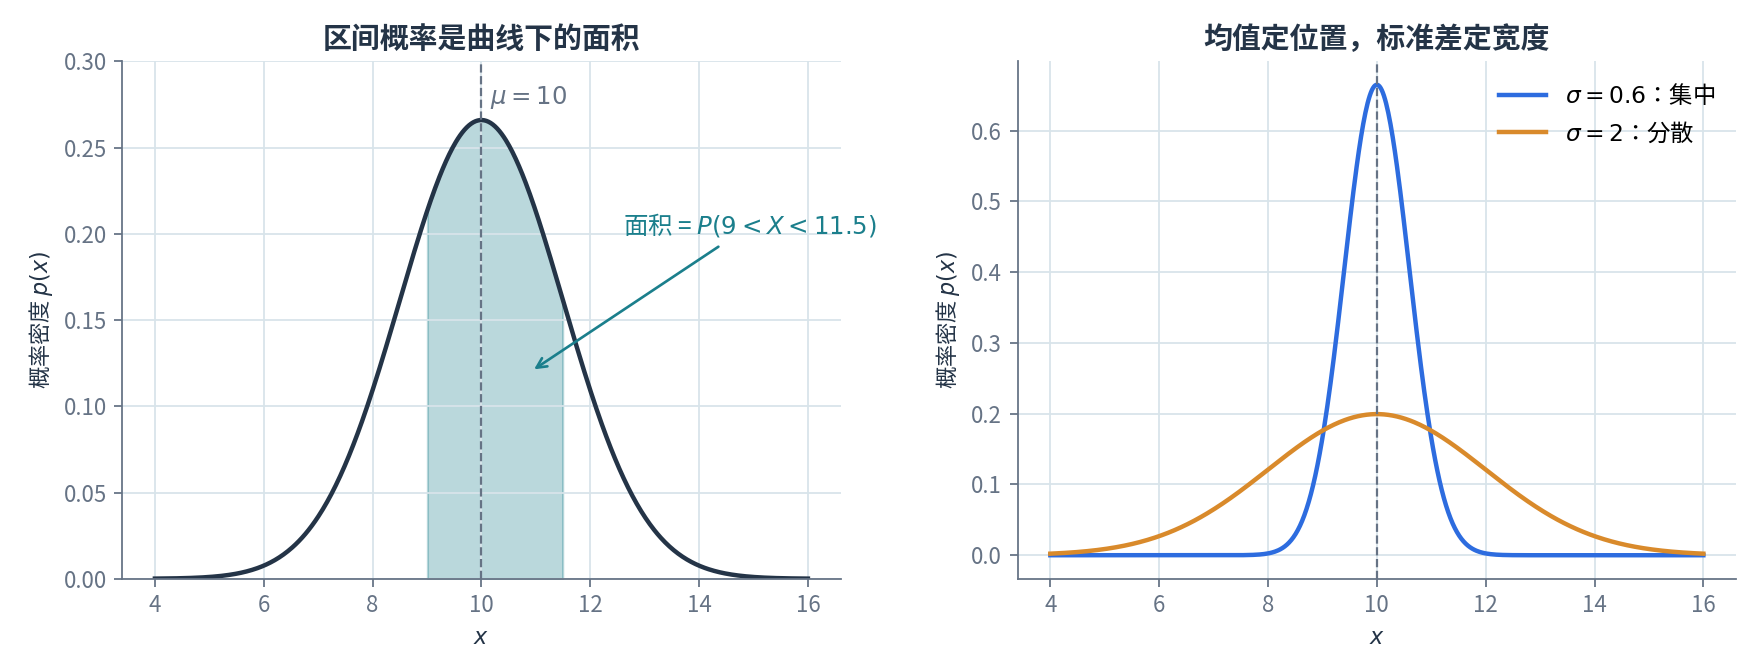
连续随机变量用概率密度函数 p(x) 描述。曲线越高,随机变量越容易落在附近。密度本身不是概率,区间 [a,b] 的概率是曲线下的面积:
P(a<X<b)=∫abp(x)dx,∫−∞+∞p(x)dx=1.
四、期望、方差与标准差
期望 E[X](常记为 μ)是随机变量长期平均意义上的中心。例如传感器反复测量一个真实位置为 10 m 的物体,读数 9.98、10.02、10.01、9.99、10.03 都围绕 10 波动,可能有 E[X]=10。
只有期望还不够。两个传感器的读数如下:
| 传感器 |
读数 |
| A |
9.99、10.01、10.00、9.98、10.02 |
| B |
7、13、8、12、10 |
两者均值都接近 10,但 A 明显更稳定。描述数据有多分散需要方差:
Var(X)=E[(X−μ)2],μ=E[X].
X−μ 是单次结果偏离中心的距离。偏差有正有负,例如 12−10=2、8−10=−2,直接平均会互相抵消;平方后都等于 4,才能反映真实的偏离程度。方差越小,数据越集中;方差越大,数据越分散。
标准差是方差的平方根:
σ=Var(X).
它和原变量的单位相同,因此比方差更直观。
五、三个常用分布
Bernoulli 分布描述只有两种结果的试验,例如碰撞/不碰撞、检测到/没检测到:
X={1,0,成功失败
均匀分布 X∼U(0,10) 表示 X 在区间 [0,10] 内每个位置被抽到的机会相同,采样式路径规划中最常用。
高斯分布(也叫正态分布)是机器人领域最重要的分布:
X∼N(μ,σ2).
均值 μ 决定曲线中心的位置,例如 X∼N(10,σ2) 集中在 10 附近;方差 σ2 决定曲线的宽度(见上图右侧)。一句话概括:均值说明“在哪里”,方差说明“有多不确定”。
六、随机向量与协方差
无人机的状态通常是向量。如果三维位置的每个分量都有不确定性,就得到随机向量,它的期望也是向量:
X=XxXyXz,μ=E[X]=1052.
这表示无人机大约位于 (10,5,2),但位置并不完全确定。
方差描述单个变量自身的波动,协方差描述两个变量是否一起变化:
Cov(X,Y)=E[(X−E[X])(Y−E[Y])].
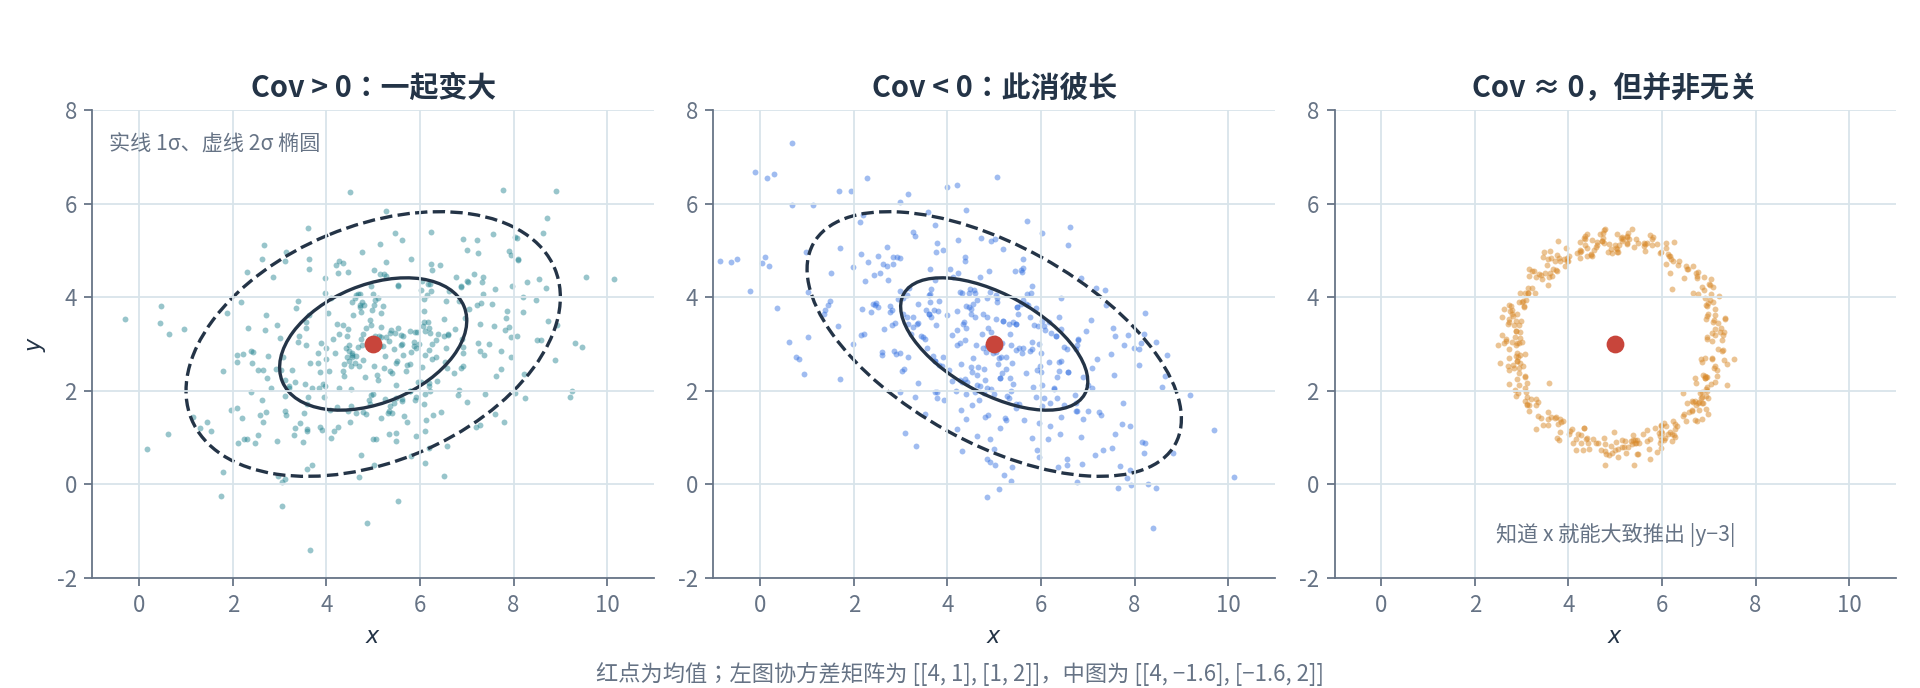
- Cov(X,Y)>0:X 增大时 Y 往往也增大;
- Cov(X,Y)<0:X 增大时 Y 往往减小;
- Cov(X,Y)≈0:没有明显的线性共同变化趋势。
协方差只反映线性关系,协方差为零不代表两个变量无关。下图右侧的点分布在一个圆环上,协方差接近零,但知道 x 就能大致推出 y 离中心多远。
七、协方差矩阵与误差椭圆
随机向量的方差和协方差排成一个矩阵,称为协方差矩阵。以二维为例:
Σ=[Var(X1)Cov(X2,X1)Cov(X1,X2)Var(X2)],例如Σ=[4112].
- 对角线 4 和 2 分别是 X1、X2 的方差,即每个方向各自的不确定程度;
- 非对角线 1 是两个变量的协方差,即它们如何一起变化。
协方差矩阵有直观的几何意义。假设无人机位置估计为 μ=[5, 3]⊤,大量可能的真实位置会围绕均值形成一团点云,等概率轮廓是一个椭圆,称为误差椭圆。椭圆的大小、方向和扁平程度都由协方差矩阵决定,上图左侧就是这个 Σ 对应的点云和椭圆。
八、多元高斯分布
把一维高斯推广到向量 X∈Rn:
X∼N(μ,Σ),
其中 μ 是均值向量,Σ 是协方差矩阵。例如
p∼N1052,Σ
表示无人机最可能在 (10,5,2) 附近,不确定性的大小和方向由 Σ 描述。
九、贝叶斯公式
P(A∣B)=P(B)P(B∣A)P(A).
入门时不必急于推导,重点是它背后的思想:用新的观测修正原来的判断。例如无人机原本估计自己在 x≈10,传感器测得 z=10.2,把之前的估计和新测量结合,就得到更新后的位置判断。状态估计、Kalman Filter、SLAM 都建立在这个思想上。
十、随机采样与 RRT
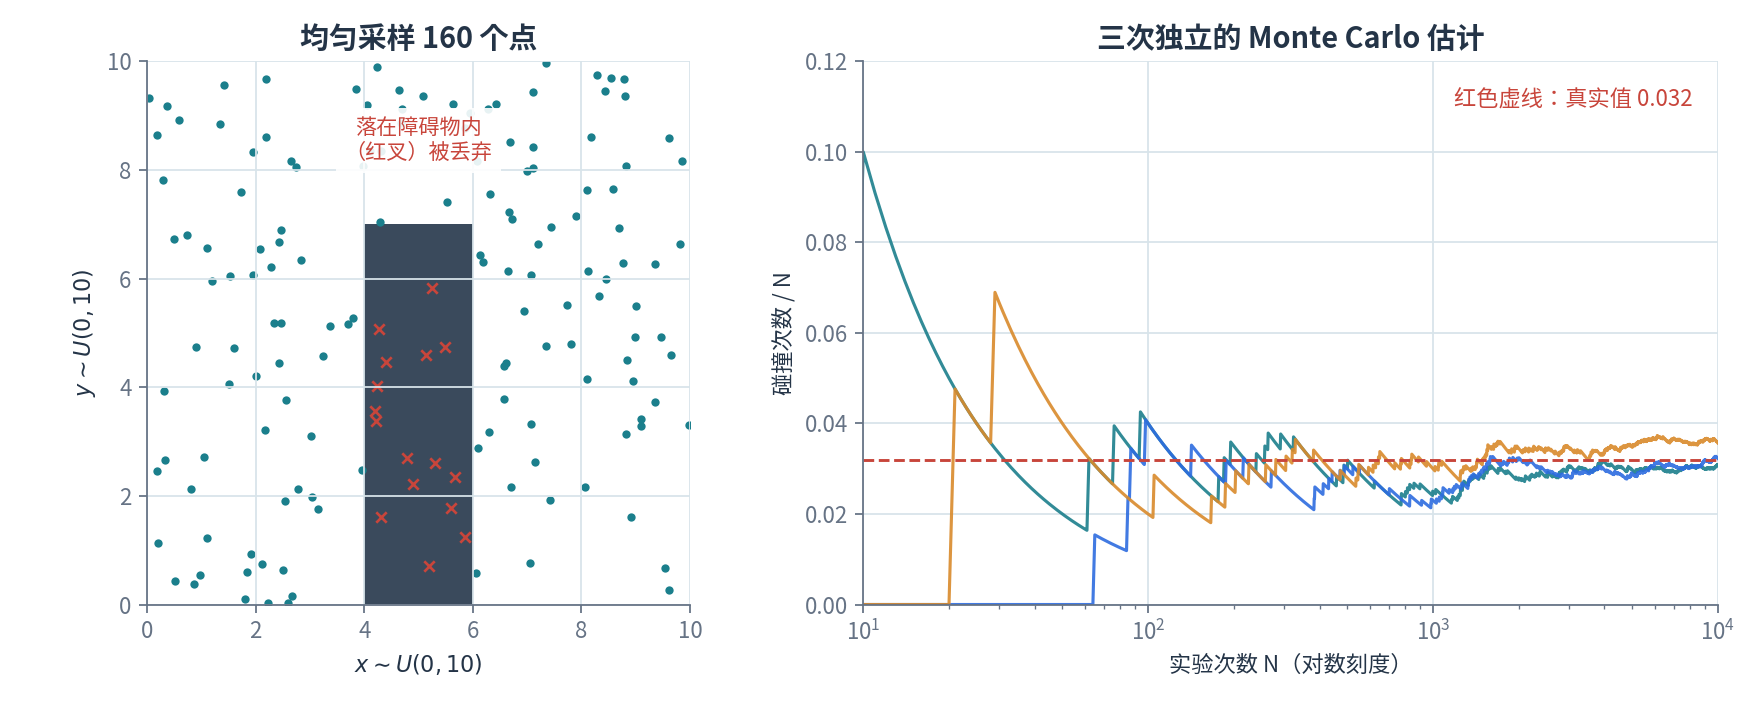
随机采样是按某个概率分布随机生成数据。例如按 X∼U(0,10) 依次采样,可能得到 2.7, 8.1, 4.3, 0.9,…。在二维空间中分别采样 x∼U(0,10)、y∼U(0,10),就得到随机点
q=[xy].
不断采样后,点会大致均匀地铺满整个区域,这是采样式路径规划的基础。
RRT 每一轮先在状态空间或构型空间 X 中随机取一个点:
qrand∼X,
再找到搜索树中离它最近的节点 qnear,从 qnear 朝 qrand 扩展。所以 RRT 的“随机”就是概率论中的随机采样,具体过程见《RRT 搜索树逐步推导》。
十一、概率完备性
RRT、PRM 等采样式方法的理论保证叫概率完备性:如果问题在相应条件下存在可行解,随着采样数量 N 增加,找到解的概率趋近于 1:
P(找到可行解)→1,N→∞.
这并不表示算法在有限时间内一定能找到路径。“概率趋近于 1”和“必然发生”是两回事:采样 100 次没找到很正常,采样 10000 次机会更大,采样越多,失败概率越小,但始终不为零。
十二、Monte Carlo 与大数定律
Monte Carlo 方法的思想是:问题难以直接计算时,就随机模拟很多次,用统计结果近似答案。
例如要估计某条轨迹因定位误差发生碰撞的概率,可以按位置误差的分布随机采样 p1,p2,…,pN,逐一检查是否碰撞。若 10000 次实验中有 320 次碰撞,则
P(collision)≈10000320=0.032,
即约 3.2%。
这种做法的依据是大数定律:对独立实验 X1,X2,…,XN 取平均
Xˉ=N1i=1∑NXi,
N 越大,Xˉ 通常越接近期望 E[X]。实验次数越多,偶然性越容易被平均掉:10 次实验的结果可能波动很大,100000 次实验的统计结果就稳定得多。入门阶段理解这一直觉即可,不必研究严格证明。
十三、与线性代数的联系
概率论和线性代数联系紧密。协方差矩阵 Σ 满足
Σ=Σ⊤,Σ⪰0,
即协方差矩阵是对称半正定矩阵。对称矩阵、特征值与特征向量、正定与半正定、二次型等概念都会在概率模型中再次出现。例如二次型
(x−μ)⊤Σ−1(x−μ)
衡量点 x 离分布中心有多“远”,它的等值线正是上面的误差椭圆或椭球,椭圆的主轴方向就是 Σ 的特征向量。相关内容见《线性代数》和《矩阵分解》。
十四、容易混淆的概念
| 容易混淆 |
正确理解 |
| 概率与概率密度 |
概率满足 0≤P(A)≤1;密度 p(x) 可以大于 1,积分后才是概率 |
| 期望与“一定出现的值” |
骰子 E[X]=3.5,但永远掷不出 3.5;期望只是平均意义上的中心 |
| 方差大小 |
N(10,0.01) 与 N(10,100) 均值相同,后者分散得多 |
| 方差与协方差 |
Var(X) 描述单个变量的波动;Cov(X,Y) 描述两个变量如何共同变化 |
| 随机与无规律 |
单次结果不可预测,但大量结果有稳定的统计规律,这正是概率论研究的对象 |
十五、学到什么程度就够了
能自然地回答下面的问题,概率基础就足以支撑采样式运动规划的学习:
- 随机变量和普通变量有什么区别?
- E[X] 和 Var(X) 分别表示什么?有了均值为什么还需要方差?
- X∼N(μ,σ2) 和 X∼N(μ,Σ) 是什么意思?
- Cov(X,Y) 描述什么?协方差矩阵 Σ 的对角线与非对角线分别代表什么?
- RRT 中的 qrand 为什么叫随机采样点?
- 为什么 P(找到路径)→1 不能理解成“有限时间内一定找到路径”?
建议的学习顺序与重要程度:
| 顺序 |
内容 |
重要程度 |
| 1–4 |
随机试验、样本空间、事件;概率基本规则;条件概率;独立性 |
基础到重点 |
| 5–7 |
随机变量;离散与连续随机变量;概率密度 |
非常重要 |
| 8–9 |
期望;方差与标准差 |
非常重要 |
| 10–11 |
均匀分布;高斯分布 |
非常重要 |
| 12–14 |
随机向量;协方差与协方差矩阵;多元高斯 |
非常重要 |
| 15 |
贝叶斯思想 |
理解 |
| 16–17 |
随机采样;Monte Carlo |
非常重要 |
| 18 |
概率完备性的直觉 |
结合路径规划学习 |
以下内容暂时不必深入,研究需要时再针对性补充:复杂排列组合、各种特殊分布、矩母函数与特征函数、测度论、随机过程的严格理论、大数定律与中心极限定理的严格证明、马尔可夫链的收敛理论。
小结
概率论要解决的核心问题是:一个量无法完全确定时,怎样用数学描述这种不确定性。
- 随机变量 X 表示存在不确定性的量;
- 期望 E[X] 描述它大致在哪里,方差 Var(X) 描述它有多分散;
- 协方差 Cov(X,Y) 描述两个变量如何共同变化;
- 多维情况下,X∼N(μ,Σ) 用 μ 表示中心,用 Σ 描述不确定性的形状;
- 采样式路径规划用 qrand 不断随机探索搜索空间,概率完备性和 Monte Carlo 估计都建立在大量采样之上。