多元微积分主要回答:变量改变一点,代价会怎样变化;能否用一个简单模型近似当前附近的函数;怎样对整段运动累计代价并求导。
本文的主线是 偏导数 → 梯度与 Jacobian → 链式法则 → Hessian 与局部模型 → 积分代价。先沿着例子读懂变化如何传递,再使用求导公式;Newton、Gauss–Newton 和隐式求导放在文末,学习相应优化方法时再读。
全文使用列向量表示变量和梯度,∥⋅∥ 默认是欧氏范数。内积和二次型的含义可参照线性代数。
1. 偏导数与梯度:多个变量怎样影响一个数?
先区分输入与输出
标量函数 f:Rn→R 接收 n 个输入,输出一个数;向量函数 F:Rn→Rm 则同时输出 m 个数。例如:
f(x,y)=x2+2y2,F(x,y)=[x2+yxy].
“多元”指输入变量多,不代表输出一定是向量。三维曲线 p(t)=(x(t),y(t),z(t))T 只有时间这一个输入,却有三个输出。
偏导数:固定其他变量,只改变一个变量
一元函数 g(x)=x2 在输入增加 h 后:
g(x+h)−g(x)=2xh+h2≈g′(x)h,g′(x)=2x.
导数描述当前附近的变化比例。输入变化足够小时,才能用它预测有限变化。
对 f(x,y)=x2+2y2,固定 y,只对 x 求导;再固定 x,只对 y 求导:
∂x∂f=2x,∂y∂f=4y.
把函数想象成地形高度,在 (1,1) 处,沿 x 轴正方向的坡度为 2,沿 y 轴正方向的坡度为 4。
“其他变量固定”并不等于删掉含有它的项。例如对 xy 关于 x 求偏导时,y 只是一个固定系数,所以 ∂(xy)/∂x=y;同理 ∂(xy)/∂y=x。
梯度把各个偏导数放在一起
梯度是一个列向量:
∇f=∂f/∂x1⋮∂f/∂xn.
当函数可微时,多个输入同时发生微小变化,各方向的一阶贡献可以相加:
Δf≈∂x1∂fΔx1+⋯+∂xn∂fΔxn=∇fTΔx.
对前面的例子,在 (1,1) 处取 Δx=0.01、Δy=0.02:
Δf≈[24][0.010.02]=0.10.
真实变化是 0.1009,多出来的 0.0009 来自被忽略的 (Δx)2+2(Δy)2。这相当于用切平面近似当前位置附近的曲面。
常见写法 df=∇fTdx 称为全微分。df 是线性模型的预测,Δf 是真实变化,一般只能写 Δf≈df。
这里的 可微 指:存在一个统一的线性模型,能描述任意足够小位移的一阶变化。只知道各偏导数存在还不够;一阶偏导在邻域内连续是常用的充分条件。本文的多项式例子满足这一条件,绝对值拐点、距离场切换点则要单独检查。
梯度为什么与下降方向有关?
沿单位方向 u 的变化率为:
Duf=∇fTu=∥∇f∥cosθ.
因此梯度非零时,它指向局部最陡上升方向,负梯度指向局部最陡下降方向。与梯度垂直的方向一阶变化为零,所以非零梯度也是等高线或等值面的法向量。
“最陡”以当前坐标下的欧氏长度为标准,比较方向时要归一化;变量尺度不同也会影响数值梯度。
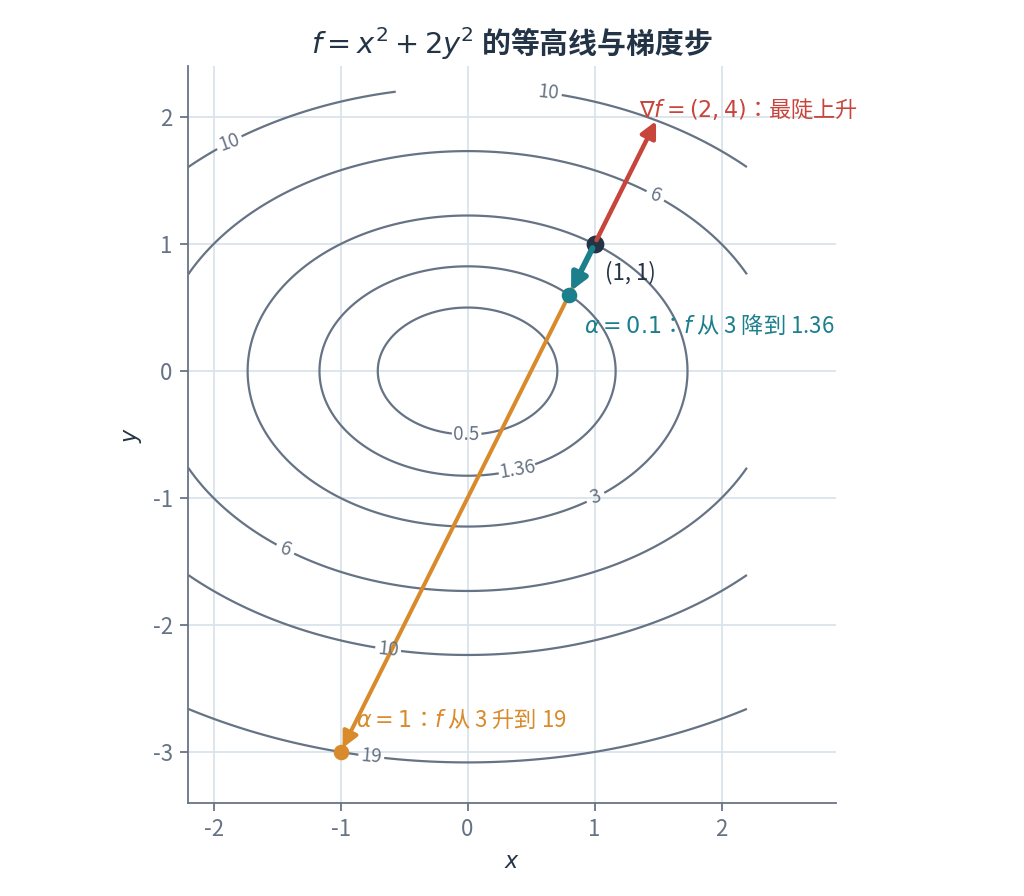
梯度下降写成:
xk+1=xk−α∇f(xk),α>0.
这里 k 是优化迭代编号。对于 f=x2+2y2,从 (1,1) 出发:
| 步长 |
新位置 |
函数值变化 |
| α=0.1 |
(0.8,0.6) |
3→1.36 |
| α=1 |
(−1,−3) |
3→19 |
方向正确,步长过大仍可能使代价上升。梯度为零时,也不能仅凭一阶信息判断是否达到最小值。
2. Jacobian:多个输入怎样影响多个输出?
定义:每行对应输出,每列对应输入
对于:
F(x)=F1(x)⋮Fm(x),
Jacobian,又称雅可比矩阵,定义为:
JF(x)=∂x1∂F1⋮∂x1∂Fm⋯⋱⋯∂xn∂F1⋮∂xn∂Fm.
这里,x=(x1,…,xn)T 包含 n 个输入,F1,…,Fm 是 m 个输出;每个 Fi 都是一个标量函数。Jacobian 把所有“输入对输出的变化率”排成一张 m×n 的表:第 i 行对应输出 Fi,第 j 列对应输入 xj。
第 i,j 个元素 ∂Fi/∂xj 表示:保持其他输入不变时,输出 Fi 随输入 xj 变化的瞬时变化率。当多个输入同时发生微小变化时,对于可微函数,可以把它们对同一个输出的一阶影响相加:
ΔFi≈∂x1∂FiΔx1+⋯+∂xn∂FiΔxn.
这正是 Jacobian 的第 i 行与输入变化向量 Δx 相乘的结果。整个矩阵乘法 JFΔx,就是一次算出所有输出的近似变化量,相当于把一元函数的 Δf≈f′(x)Δx 推广到多个输入、多个输出。
一个完整例子
设:
F(x,y)=[x2+yxy].
分别对每个输出求偏导:
JF(x,y)=[2xy1x].
在 (1,1) 处:
JF(1,1)=[2111].
输入变化 Δx=(0.01,0.02)T,则:
ΔF≈[2111][0.010.02]=[0.040.03].
真实变化为 (0.0401,0.0302)T。
与梯度的关系
对于可微向量函数:
F(x+Δx)≈F(x)+JF(x)Δx.
Jacobian 是非线性函数在当前位置附近对应的线性变换矩阵。它作用于输入的微小变化,而不是一般地满足 F(x)=JF(x)x。
Jacobian 通常随位置变化。只有仿射函数 F(x)=Ax+b 的 Jacobian 始终等于固定矩阵 A。
对于标量函数,按照本文的列梯度约定:
Jf=∇fT.
它们包含同一组偏导数,但排列方向不同。
3. 链式法则:把变化沿依赖关系传递
一个输入通过多个中间变量影响输出
设 x=x(t)、y=y(t),而输出为 f(x,y):
t⟶(x,y)⟶f.
链式法则为:
dtdf=∂x∂fdtdx+∂y∂fdtdy.
每条途径都用“输出对中间变量的变化率”乘以“中间变量的变化率”,最后相加。
例如 f=x2+2y2,x=t,y=t2:
dtdf=2x⋅1+4y⋅2t=2t+8t3.
直接代入 f=t2+2t4 再求导,也得到同一结果。
如果标量场还显式依赖时间,沿 p(t) 的总变化率为:
dtdf(p(t),t)=∂t∂f+∇pfTp˙.
第一项是固定位置时场本身的变化,第二项是因位置移动而产生的变化。因此 ∂f/∂t 和 df/dt 一般不同。
向量复合函数:Jacobian 按顺序相乘
设 x=G(θ)、y=F(x)。由:
dx=JGdθ,dy=JFdx,
得到:
JF∘G=JFJG.
右侧矩阵先把参数变化变成中间变量变化,左侧矩阵再把它变成输出变化。所有导数都在当前对应位置求值。
标量代价对参数求梯度:为什么有转置?
设 p=p(θ),代价为 C(θ)=f(p(θ))。先写微分:
dC=∇pfTdp=∇pfTJpdθ.
与 dC=∇θCTdθ 对照,得到:
∇θC=JpT∇pf.
若 p∈Rd、θ∈Rk,右边维度为 (k×d)(d×1)=k×1,恰好对应每个参数的一个偏导数。
例如:
p(u,v)=[u+v2v],f(x,y)=x2+2y2.
则:
∇(u,v)C=JpT[1102]∇pf[2(u+v)8v]=[2u+2v2u+18v].
直接对 C(u,v)=(u+v)2+8v2 求导可以验证。这里最值得熟练的是:先对中间变量求梯度,再通过 Jacobian 转成真正优化参数的梯度。
4. Hessian 与 Taylor 展开:从坡度到局部形状
Hessian 是梯度的 Jacobian
一阶偏导数仍然是函数,可以继续求导。Hessian(海森矩阵)把这些二阶偏导排成矩阵:
Hf=J∇f=∇2f,(Hf)ij=∂xj∂(∂xi∂f).
二维时,记 fxy=∂(fx)/∂y,有:
Hf=[fxxfyxfxyfyy].
例如:
f=x2+2y2⟹Hf=[2004].
换成 g=x2+2xy+3y2,则 Hg=[2226]。混合偏导 gxy=2 表示:沿 x 方向的坡度,也会随 y 改变。
二阶偏导在邻域内连续时,混合偏导相等,Hessian 对称;对称不等于正定。
在足够光滑时,它描述梯度的变化:
∇f(x+Δx)≈∇f(x)+Hf(x)Δx.
| 对象 |
描述什么 |
维度 |
| 梯度 ∇f |
标量输出怎样变化 |
n×1 |
| Jacobian JF |
多个输出怎样变化 |
m×n |
| Hessian Hf |
梯度本身怎样变化 |
n×n |
Hessian 不是梯度的平方,也不同于外积 ∇f∇fT。
Taylor 展开把导数组成局部模型
对二阶连续可微函数,在当前位置附近:
f(x+Δx)≈f(x)+∇fTΔx+21ΔxTHfΔx.
三部分分别是当前位置的高度、一阶倾斜和二阶弯曲。去掉最后一项,就是前面用过的线性近似。
二次项前的 1/2 可以用 x2 理解:二阶导数为 2,乘上 1/2 才还原出 (Δx)2 的系数。
对 f=x2+2y2,二次项为:
21[ΔxΔy][2004][ΔxΔy]=(Δx)2+2(Δy)2.
它恰好补上第 1 节线性近似漏掉的部分。因为这个函数本来就是二次函数,此处的二阶模型是精确的;一般非线性函数仍只能在附近使用。
Hessian 能怎样判断极值?
沿单位方向 u 看一元函数 φ(s)=f(x+su),其二阶变化率为:
φ′′(0)=uTHfu.
如果 u 是单位特征向量,对应特征值就是这个方向上的二阶变化率。这把 Hessian 与前一篇的“碗、槽、鞍面”联系起来。
无约束内部极小点必须满足 ∇f=0,这样的点称为驻点。在二阶连续可微的前提下:
| 驻点处 Hessian |
结论 |
| 正定 |
严格局部极小点 |
| 负定 |
严格局部极大点 |
| 不定 |
鞍点 |
| 半正定或半负定,且有零特征值 |
二阶信息一般不足以判定 |
例如 x2−y2 在原点梯度为零,但原点是鞍点。x2+y4 与 x2−y4 在原点甚至有相同的半正定 Hessian,却分别是极小点和鞍点,因为 Hessian 看不见四次项。
还要区分局部形状与全局凸性:在开凸定义域上的二阶连续可微函数,只有 Hessian 在整个定义域都半正定,才能由这个条件判断函数凸。凸函数的驻点是全局极小点;只检查一个点的 Hessian 不够。
5. 常见代价怎样求导?
下面都采用列梯度,a,b,A 固定,Q,W 为实对称矩阵:
| 函数 |
梯度 |
Hessian |
| aTx+b |
a |
0 |
| 21xTQx+cTx |
Qx+c |
Q |
| 21∥x−a∥2 |
x−a |
I |
| 21(x−a)TW(x−a) |
W(x−a) |
W |
| 21∥Ax−b∥2 |
AT(Ax−b) |
ATA |
这些公式可以用全微分和链式法则得到。例如令 r=Ax−b:
d(21rTr)=rTdr=rTAdx=(ATr)Tdx.
所以梯度为 ATr。这比单独背诵每个公式更容易推广到其他残差。
使用时注意三个区别:
- 有没有 1/2:xTQx 的梯度是 2Qx。
- 矩阵是否对称:若 Q 不对称,21xTQx 的梯度是 21(Q+QT)x。
- 距离与距离平方不同:d=∥x−a∥ 在 x=a 处有 ∇d=(x−a)/∥x−a∥,而在目标点不可微;距离平方仍然光滑。
这些导数表达式也不等于求解算法。例如最小二乘的 Hessian 是 ATA,并不意味着数值求解必须显式构造正规方程。
6. 参数化曲线:对时间求导,对整段积分
同一条曲线可以有不同的时间安排
几何路径记为 r(s),其中 s 是参数,未必是时间或弧长。给定 s=s(t),就得到轨迹:
p(t)=r(s(t)).
链式法则给出:
p˙=r′(s)s˙,p¨=r′′(s)s˙2+r′(s)s¨.
速度同时取决于曲线形状和推进快慢;加速度还取决于方向怎样改变。同一条空间曲线,时间安排不同,速度和加速度也不同。
| 量 |
定义 |
单位(位置用米,时间用秒) |
| 速度 |
p˙ |
m/s |
| 加速度 |
p¨ |
m/s2 |
| jerk,加速度变化率 |
p(3) |
m/s3 |
| snap,jerk 的变化率 |
p(4) |
m/s4 |
速率 ∥p˙∥ 不变,不等于加速度为零;匀速圆周运动仍在改变速度方向。
分段函数怎样才算接得平滑?
C0 连续要求位置接上,C1 还要求速度接上,C2 进一步要求加速度接上。一般地,各段内部足够光滑时,连接处需满足:
p(j)(tk−)=p(j)(tk+),j=0,…,r.
这表示 Cr 连续;j=0 是位置本身,上标 −、+ 表示从左段和右段接近连接点。
积分就是累计局部贡献
若 ℓ(t) 是单位时间产生的代价,那么:
C≈k∑ℓ(tk)Δtk⟶C=∫0Tℓ(t)dt.
小段路程约为 ∥p˙(t)∥Δt,所以曲线长度为:
L=∫0T∥p˙(t)∥dt.
例如 p(t)=(3t,4t)T,t∈[0,1],长度就是 ∫015dt=5。
对空间代价 ρ(p),∫ρ(p(t))dt 按停留时间累计,∫ρ(p(t))∥p˙(t)∥dt 按路程累计,类似“按时长计费”和“按距离计费”。积分变量和权重不同,表达的目标也不同。
常见平滑代价为:
Cr=∫0T∥p(r)(t)∥2dt.
r=2,3,4 分别惩罚加速度、jerk、snap 的平方。它衡量累计的导数大小,不直接等于电池能耗,也不保证每个时刻的导数都低于某个上限。
7. 积分代价:怎样对系数和时间求导?
固定区间时,把每一小段的梯度相加
设 T 固定,轨迹由参数 θ 决定:
C(θ)=∫0Tℓ(p(θ,t))dt.
当函数及参数导数在相关邻域和有限积分区间上连续等条件保证可以交换求导与积分时:
∇θC=∫0TJp,θT∇pℓdt.
这里的 Jacobian 是固定 t 时位置对参数的导数。可以先把积分看成离散和:每个采样点使用链式法则求梯度,再乘对应的时间权重并相加。
若代价还通过速度影响输出,就加上 Jp˙,θT∇p˙ℓ;若采样时刻、权重或代价本身也显式依赖参数,相应的导数也要计入。
为什么平滑积分会变成二次型?
设时间与基函数固定,轨迹对系数 c 是线性的:
p(t)=B(t)c,p(r)(t)=Br(t)c,Br(t)=dtrdrB(t).
其中 c∈RK,B(t)∈Rd×K。代入平滑积分:
Cr(c)=∫0T∥Br(t)c∥2dt=cT[∫0TBr(t)TBr(t)dt]c=cTQc.
Q 对称半正定,因为对任意 z,有 zTQz=∫0T∥Br(t)z∥2dt≥0。因此:
∇cCr=2Qc,HCr=2Q.
用二次多项式看一次:
p(t)=c0+c1t+c2t2,p′′(t)=2c2,C2=4Tc22.
对应 Q=diag(0,0,4T)。改变 c0,c1 不影响加速度,所以这个代价存在平坦方向,边界条件才会进一步限制它们。
优化时间时,要同时考虑区间和函数的变化
若 C(T)=∫0TL(T,t)dt,在适当光滑条件下:
dTdC=L(T,T)+∫0T∂T∂L(T,t)dt.
第一项来自积分区间延长,第二项来自原区间内函数自身改变。例如 L(T,t)=Tt,则 C(T)=T3/2;求导得到 T2+T2/2=3T2/2,不能只保留上限处的值。
时间归一化的两个缩放因子
设 s=t/T,T>0,p(t;T)=pˉ(t/T)。对 t 求导时固定 T,每求一次导数就乘 1/T:
p(r)(t)=T−rpˉ(r)(s).
积分还需换元 dt=Tds,所以:
Cr(T)=∫01T−2r∥pˉ(r)(s)∥2Tds=T1−2rCˉr,Cˉr=∫01∥pˉ(r)(s)∥2ds.
| 导数平方积分 |
固定归一化形状时的缩放 |
| 加速度 |
T−3 |
| jerk |
T−5 |
| snap |
T−7 |
同一归一化形状的总时间扩大到两倍,snap 平方积分变成原来的 1/128。保持这个形状不变时:
dTdCr=(1−2r)T−2rCˉr.
固定归一化形状是这个求导结果的前提。如果改变 T 后,为满足固定的物理端点速度、加速度而重新调整形状,Cˉr 也会变化;同理,系数形式中的 Q(T) 不能继续视为常量。
8. 两个例子:距离罚项与相邻点代价
距离罚函数如何求梯度?
设 d(p) 表示带符号距离,约定障碍外为正、内部为负。安全阈值为 dsafe>0,构造:
ϕ(p)=[max(0,dsafe−d(p))]2.
在距离可微的位置:
∇ϕ(p)={−2(dsafe−d(p))∇d(p),0,d(p)<dsafe,d(p)≥dsafe.
负号来自内层函数:
∇(dsafe−d)=−∇d.
对于球心 o、半径 R 的球形障碍:
d(p)=∥p−o∥−R.
当 p=o 时:
∇d(p)=∥p−o∥p−o.
它指向远离球心的方向。罚项激活时,负梯度 −∇ϕ 也指向距离增大的方向。
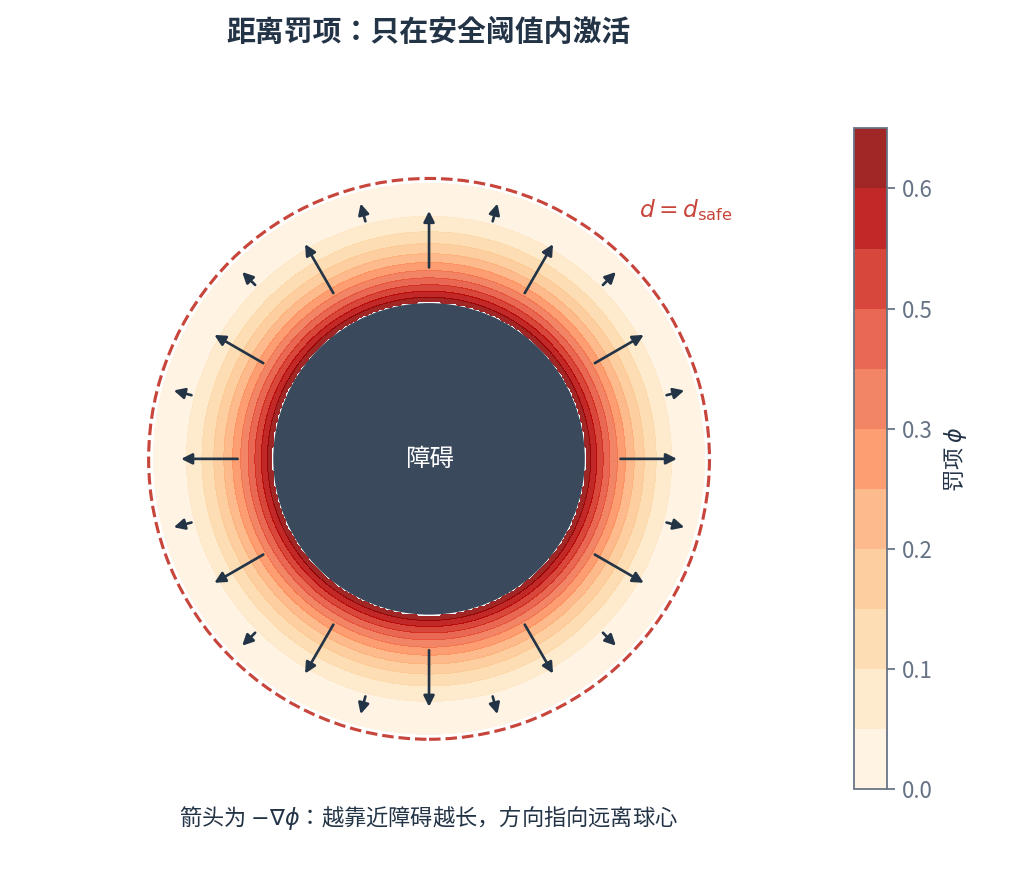
需要区分两个光滑性问题:如果 d 是 C1,平方正部函数使 ϕ 在激活边界处仍具有连续的一阶导数,但一般不保证二阶可微;距离函数本身也可能在球心、最近障碍切换等位置不可微。
若位置由参数控制,则再使用一次链式法则:
∇θϕ=Jp,θT∇pϕ.
离散点怎样一起优化?
设起点 p0、终点 pN+1 固定,中间点 p1,…,pN 可调整,每个点属于 Rd。
把中间点堆叠成:
q=p1⋮pN∈RdN.
定义简化目标:
C(q)=i=0∑N∥pi+1−pi∥2+λi=1∑Nϕ(pi),λ>0.
对内部点 pi,只有两个相邻距离项与该点的罚项有关:
∇piC=2(pi−pi−1)+2(pi−pi+1)+λ∇ϕ(pi).
整理为:
∇piC=4(pi−2pi−1+pi+1)+λ∇ϕ(pi).
第一项的负梯度将该点拉向两个邻居的中点;第二项使该点朝位置罚项下降的方向移动。
例如暂时忽略罚项,取:
pi−1=[00],pi=[11],pi+1=[20].
梯度为 (0,4)T,负梯度向下,恰好把折线中间凸起的点拉向邻居中点。
这个例子还说明了三个边界:距离平方之和不是实际折线长度;有限权重的罚项不是硬安全约束;路径点安全也不自动证明相邻点之间的连接段安全。
更新式:
qk+1=qk−α∇C(qk)
中的 k 是优化迭代编号,不是物理时间。它表示修改候选路径,不是直接规定飞行速度。
9. 用有限差分检查导数
推导完梯度后,最好对照函数值检查一次。令 ei 为第 i 个坐标方向的单位向量,中心差分为:
∂xi∂f≈2hf(x+hei)−f(x−hei).
变量较多时,可以选择单位方向 u,比较:
∇f(x)Tu与2hf(x+hu)−f(x−hu).
左侧是解析梯度的预测,右侧用两次函数求值估计。应在多个位置、多个方向,以及结合变量尺度选择的几个步长下比较。
h 过大时不够局部;过小时,两个接近的浮点数相减会放大舍入误差。因此步长不是越小越好。
还要留意不可微位置。例如 f(x)=∣x∣ 在原点不可微,但中心差分 (∣h∣−∣−h∣)/(2h) 始终为零。差分是排查求导错误的工具,不能代替对光滑性的判断。
读到这里,重点是能自己算出一个代价的梯度,沿参数依赖关系把它传回去,再用数值变化验证。下面两部分可在学习相应优化方法时再读。
补充一:导数怎样进入优化方法?
Newton:让局部模型的梯度为零
对当前位置的二次模型求驻点,得到:
HfΔx=−∇f.
这就是一个线性系统:Hessian 为系数矩阵,负梯度为右端项,待求的是更新量。
对 f=x2+2y2,从 (1,1) 出发:
[2004][ΔxΔy]=−[24]⟹Δx=Δy=−1.
一步到原点,是因为这个例子的二次模型恰好等于原函数。一般非线性问题仍要控制步长或采用其他机制;Hessian 不定时,上式求出的驻点不一定是模型的最小点。
Gauss–Newton:先把残差线性化
设残差向量 r(x),目标为 f=21∥r∥2。链式法则和乘积法则给出:
∇f=JrTr,Hf=JrTJr+i∑riHri.
Gauss–Newton 使用 Hf≈JrTJr,相当于先线性化残差,再求一个局部最小二乘问题。残差较小且其二阶导数受控时,忽略项可能较小;不能把该近似总当作精确 Hessian。
约束:只允许沿某些方向移动
等式约束 c(x)=0 的线性化为:
JcΔx=−c(x).
若当前位置可行,则切向方向满足 JcΔx=0,对应 Jacobian 的零空间。弯曲约束面上的切线只是一阶近似,走有限一步仍可能偏离约束面。
例如最小化 x2+y2,要求 x+y=1。最优点 (1/2,1/2) 的梯度是 (1,1)T,并不为零,却与允许的方向 (1,−1)T 垂直。负梯度方向会破坏约束,所以不能直接沿它移动。
当约束梯度线性无关、相关函数光滑时,这种关系可写成拉格朗日必要条件:
∇f+JcTλ=0,c(x)=0.
它表示目标梯度可以由约束法向量组合出来,用于寻找候选点,本身不保证全局最优。完整的 KKT 条件与约束优化算法留到最优化部分展开。
补充二:变量由线性系统决定时,怎样继续求导?
阅读系数恢复或 MINCO 一类参数化的梯度传播时,再使用这一节。它把前面的链式法则与线性系统求解联系起来。
对定义方程求微分
设系数 c 由参数 θ 决定,但需要先解线性系统:
A(θ)c(θ)=b(θ).
假设 A,b 可微,且 A 在所讨论位置附近可逆。如何求 c 对参数的导数?
对等式两边取微分,使用乘积法则:
(dA)c+Adc=db.
整理得到:
Adc=db−(dA)c.
对于某个标量参数 θj:
A∂θj∂c=∂θj∂b−∂θj∂Ac.
先构造右端项,再解线性系统,就能得到导数,不需要显式求逆。
用一个标量方程检验符号
设:
Tc=q,T>0.
它的显式解为 c=q/T。隐式微分给出:
Tdc=dq−cdT.
因此:
∂q∂c=T1,∂T∂c=−Tc=−T2q.
与直接求导完全一致。这里的负号说明:右端目标不变时,系数矩阵增大,求解出的系数会相应减小。
只需要最终标量代价梯度时:伴随求导
设最终目标为:
C=C(c(θ),θ).
定义:
gc=∇cC,gθ,explicit=∇θCc 固定.
全微分为:
dC=gcTdc+gθ,explicitTdθ.
求解一个转置线性系统:
ATη=gc.
于是:
gcTdc=ηTAdc=ηT[db−(dA)c].
因此:
∂θj∂C=∂θj∂Cc 固定+ηT(∂θj∂b−∂θj∂Ac).
这样不必显式构造整个 Jc,θ。对一个标量目标,系数维度和参数数量较大时,这种写法尤其有意义:一次转置求解后,再计算各参数的相应收缩项。
这个推导的基础仍然只有全微分、乘积法则、链式法则和线性系统求解。
本文的学习范围衔接理论学习路线中的数学基础与连续轨迹表示部分。