从 Dijkstra 到 A*:一步一步找到最短路径
无人机要从仓库入口 S 飞到目标 G。地图已经给出了可以经过的位置,碰撞检测也筛出了可通行的连接,每条连接都有长度。沿不同路线到达目标,累计长度不同,图搜索要找出最短的那条。
本文用一张六个位置的路线图,逐轮手算 Dijkstra 和 A*,看两者怎样记录路线、选择下一个位置,以及启发函数为什么能减少搜索。
一、路线图
S 是起点,G 是终点,A、B、C、D 是中间位置。箭头表示允许通过的方向,数字是通道长度(米):
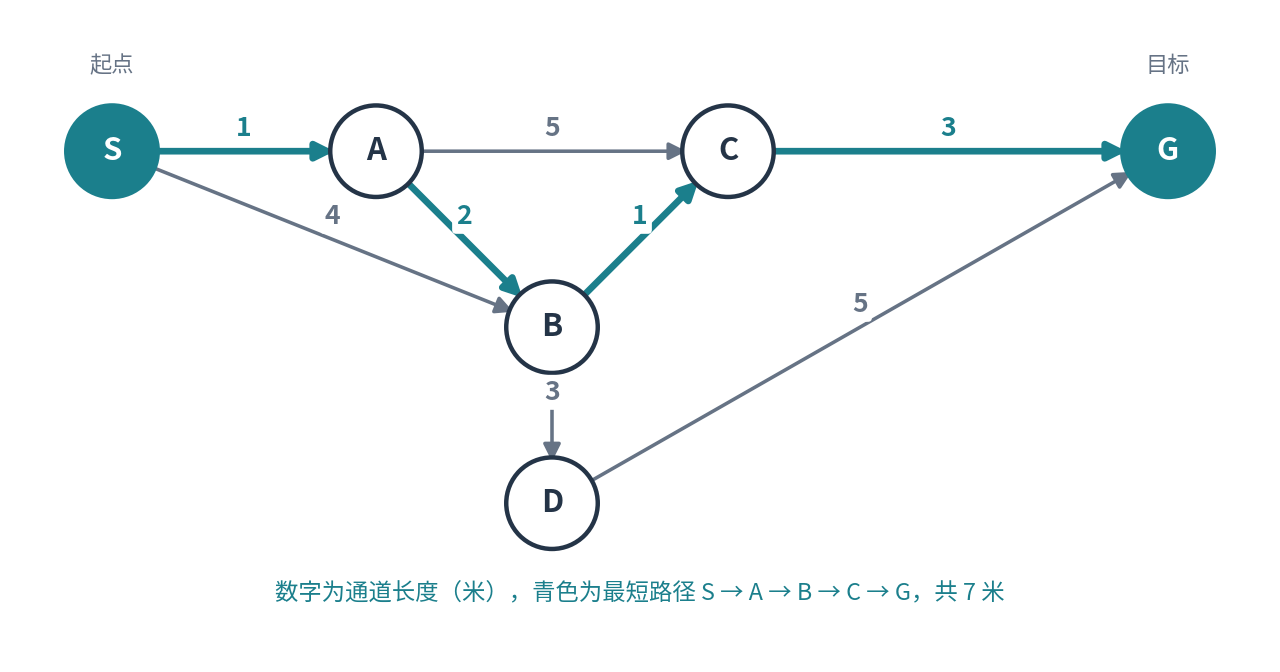
先比较两条到达 B 的路线:直接 S → B 长 4 米;S → A → B 长 米。多经过一个位置的路线反而更短。
搜索过程中,算法为 B 保存当前找到的最佳路线:先发现 4 米的就记 4 米,后来发现 3 米的就改成 3 米。记录一条路线,遇到更短的就更新,这是 Dijkstra 和 A* 共同的基本操作。
二、跟着 Dijkstra 算一遍
1. 记录表和候选清单
每个位置保存两项信息:目前找到的最短到达距离,以及这条路线最后从哪个位置接过来。另外维护一份候选清单,放入已经找到到达路线、还没检查后续连接的位置。
开始时只知道自己在 S:到达 S 的距离为 0 米,其他位置尚未找到路线;候选清单里只有 S(0 米)。
接下来反复执行同一个规则:
从候选清单中取出累计距离最小的位置,检查它的每条后续连接,更新能够改善的路线。
检查一个位置的后续连接,称为扩展。这些操作都发生在计算机中的地图上,搜索完成后才得到交给无人机执行的路线。
2. 第一轮:扩展 S
S 有两条出边:到 A 的距离 ,到 B 的距离 。候选清单变成:
| 候选位置 | 当前最佳路线 | 累计距离 |
|---|---|---|
| A | S → A | 1 米 |
| B | S → B | 4 米 |
下一轮选择 A,因为 1 米更小。B 的 4 米只表示已经找到一条 4 米的路线,之后仍可能被更好的路线更新。
3. 第二轮:扩展 A,改善到 B 的路线
经过 A 到 B 的距离为 ,比原来记录的 4 米短,所以把 B 的距离从 4 改成 3,B 的上一个位置从 S 改成 A。
经过 A 到 C 的距离为 ,这是第一次找到到 C 的路线,记录下来。
| 候选位置 | 当前最佳路线 | 累计距离 |
|---|---|---|
| B | S → A → B | 3 米 |
| C | S → A → C | 6 米 |
下一轮选择 B。注意这里比较的始终是从 S 出发的累计距离,到 A 的 1 米已经包含在里面。
4. 第三轮:扩展 B,改善到 C 的路线
经过 B 到 C 的距离为 ,比原来经过 A 的 米短,把 C 的距离从 6 改成 4,上一个位置从 A 改成 B。经过 B 到 D 的距离为 。
| 候选位置 | 当前最佳路线 | 累计距离 |
|---|---|---|
| C | S → A → B → C | 4 米 |
| D | S → A → B → D | 6 米 |
下一轮选择 C。
5. 第四轮:扩展 C,第一次发现目标
C 到 G 长 3 米,于是找到一条完整路线 S → A → B → C → G,总长 米。
| 候选位置 | 当前最佳路线 | 累计距离 |
|---|---|---|
| D | S → A → B → D | 6 米 |
| G | S → A → B → C → G | 7 米 |
Dijkstra 只按累计距离排序,所以下一轮选的是 D,而不是 G。
发现一条到达目标的路线,只是把目标加入候选清单;只有当目标成为累计距离最小的候选并被取出时,搜索才结束。
6. 第五轮:扩展 D
经过 D 到 G 的距离为 米,比已有的 7 米长,保留原记录,G 的上一个位置仍是 C。候选清单只剩 G(7 米),下一轮取出 G,搜索结束。
7. 从记录中还原路径
每次改善到达距离时,都同时记录“最后从哪里接过来”,这个位置称为前驱。最终的前驱记录是:
| 位置 | G | C | B | A |
|---|---|---|---|---|
| 前驱 | C | B | A | S |
从 G 开始往回查:G 来自 C,C 来自 B,B 来自 A,A 来自 S。反过来就是最短路径:
算法检查过 D,但最终路线并不经过 D。搜索顺序决定了计算机怎样比较方案,最后选出哪条路线由前驱记录决定。
三、为什么 Dijkstra 能确定最短距离
1. 把累计距离看成信号到达时间
想象从 S 同时沿各条通道发出信号,每走 1 米需要 1 秒。直接通往 B 的信号需要 4 秒;另一束信号先用 1 秒到 A,再用 2 秒到 B,只要 3 秒。所以 B 第一次收到信号是在第 3 秒。
Dijkstra 的处理顺序与这种传播一致:先处理累计距离小的位置,短路线的信息就能更早传给后面的位置。在例子里,A 的 1 米记录先被处理,从而在 B 以 4 米被取出之前,就把 B 更新成了 3 米。
更一般地,如果还存在一条小于 3 米的路线到 B,这条路线上每个位置的累计距离也都小于 3 米,按距离从小到大处理,就一定会先沿它传播并更新 B。因此:在边代价非负的图中,一个位置以最小累计距离被取出时,它的最短到达距离就已经确定。
2. 为什么要等到“取出目标”才结束
再看一个三个位置的例子:S → G 长 10 米,S → A → G 长 米。扩展 S 时,会同时得到 A 的 1 米和 G 的 10 米;只有继续取出 A,才能把 G 改善为 2 米。所以第一次发现目标时,得到的只是一个候选方案,必须让它参与后续比较。
如果候选清单已经空了,目标仍没有被取出,说明图中不存在连接起终点的路径。
四、A* 怎样利用目标的位置
1. 回到 Dijkstra 的一个选择
扩展完 C 后,Dijkstra 面对两个候选:D(累计 6 米)和 G(累计 7 米),它选了 D,因为只看已经走过的距离。
但目标的位置还能提供一项信息:从候选位置继续走到 G,至少还需要多远?
2. 估计“还要走多远”
给各位置设置横向坐标(米):
| 位置 | S | A | B | C | D | G |
|---|---|---|---|---|---|---|
| 横向坐标 | 0 | 1 | 2 | 3 | 2 | 6 |
| 到 G 的横向差距 | 6 | 5 | 4 | 3 | 4 | 0 |
B 和 D 在不同通道,但横向坐标相同。以 D 为例:D 的横向坐标是 2,要到横向坐标为 6 的 G,至少要完成 4 米的横向位移,纵向移动和绕行只会让路程更长。所以 4 米是从 D 到 G 剩余距离的下界。这样的估计称为启发值,计算它的方法称为启发函数。
用启发值重新比较 D 和 G:
| 候选位置 | 已走距离 | 剩余距离估计 | 两者相加 |
|---|---|---|---|
| D | 6 米 | 4 米 | 10 米 |
| G | 7 米 | 0 米 | 7 米 |
沿当前路线经过 D 继续走,总长至少 10 米;经过 C 到 G 的完整路线只有 7 米。加入剩余距离估计后,G 的优先级高于 D,这就是 A* 与 Dijkstra 在这个例子中的区别。
3. 公式
把这三个量写成:
| 符号 | 含义 | D 的例子 |
|---|---|---|
| 目前找到的从 S 到该位置的最小累计距离 | 6 | |
| 从该位置到 G 的剩余距离估计 | 4 | |
| 沿当前路线继续前往 G 的总距离估计 | 10 |
Dijkstra 选择 最小的候选,A* 选择 最小的候选。发现更短路线时,两者都更新 和前驱;A* 再用新的 加上 ,重新安排优先级。
4. 用 A* 重新算一遍
| 轮次 | 扩展 | 更新后的候选( + = ) | 下一轮选择 |
|---|---|---|---|
| 1 | S | A:1 + 5 = 6;B:4 + 4 = 8 | A |
| 2 | A | B:3 + 4 = 7(由 4 改善为 3);C:6 + 3 = 9 | B |
| 3 | B | C:4 + 3 = 7(由 6 改善为 4);D:6 + 4 = 10 | C |
| 4 | C | G:7 + 0 = 7;D:6 + 4 = 10 | G,搜索结束 |
沿前驱同样得到 S → A → B → C → G,总长 7 米。两种算法的取出顺序:
| 算法 | 取出顺序 |
|---|---|
| Dijkstra | S → A → B → C → D → G |
| A* | S → A → B → C → G |
A* 少扩展了 D,得到的最短路线相同。如果所有位置都取 ,则 ,A* 就退化成 Dijkstra。
五、在栅格地图上估计剩余距离
1. 曼哈顿距离
二维栅格中,如果每次只能上、下、左、右移动,可以先忽略障碍,数一数横向和纵向分别还差几格。例如横向差 3 格、纵向差 2 格,每格 1 米,那么至少还要走 米。这就是曼哈顿距离:
2. 加一堵墙
下图每格边长 1 米,深色格是墙(机体尺寸已经通过障碍物膨胀计入)。S 在 ,G 在 ,墙上只在 留了通道:
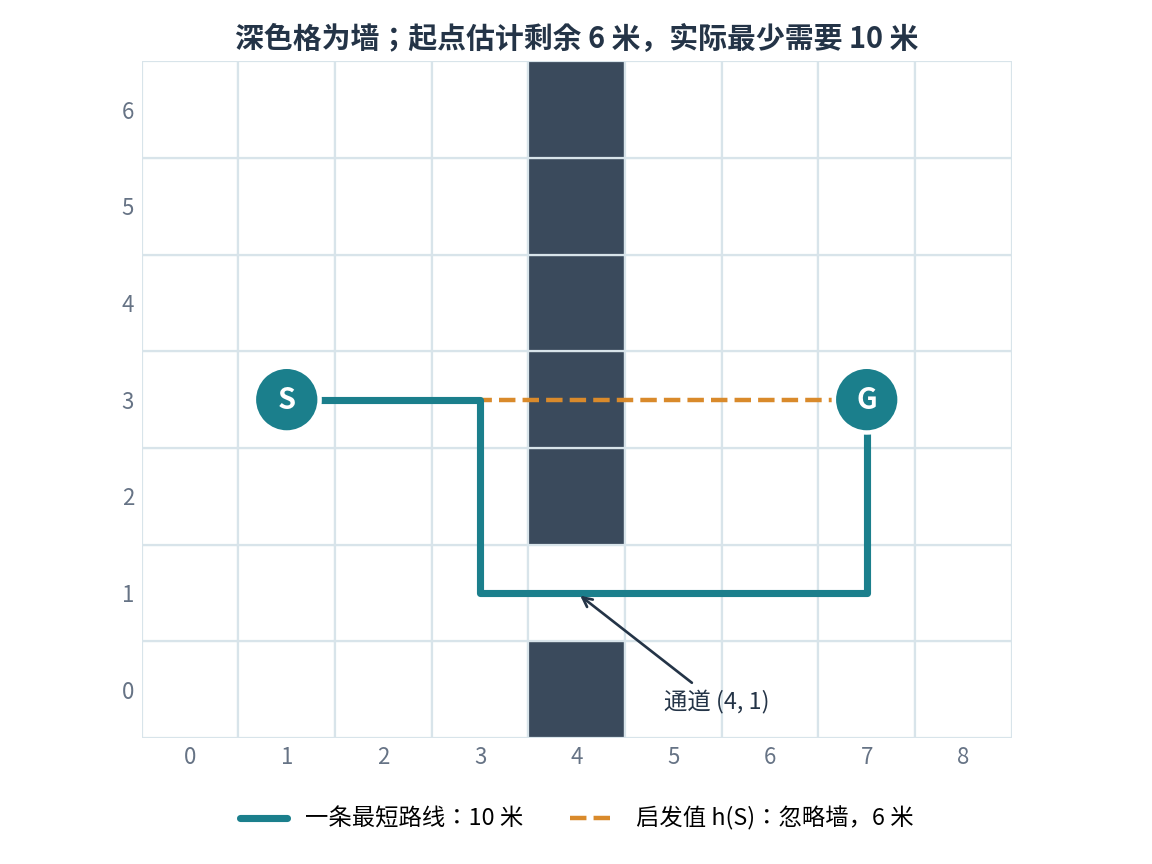
忽略墙时,横向差 6 格、纵向差 0 格,起点的启发值 。实际路线要先向下走 2 格、穿过通道、再向上走 2 格,横向仍累计 6 格,所以最短路径长 米。
估计值 6 米比实际的 10 米小。启发值给出一个偏乐观的下界,具体怎样绕行由搜索过程逐步确定。
3. 启发函数应满足的条件
可采纳性:启发值不超过真实的最小剩余代价。上面估计 6 米、实际 10 米,满足这个要求。
一致性:相邻位置的估计要能衔接,沿一条边前进,剩余估计的下降量不超过这条边的代价:
其中 是从 到 的边代价。例如在单位四邻域栅格中朝目标横向走一格,曼哈顿距离恰好减少 1 米。
本文的横向距离估计和单位四邻域中的曼哈顿距离都是一致的。在有限、搜索期间不变、边代价非负的图中,使用一致的启发函数,并在目标以最小 被取出时结束,A* 能得到最短路径。
允许斜向移动时,估计要相应调整:对角相邻的两格可以直接走 米,而横纵相加是 2 米,会高于实际距离。这时可以用直线距离,或按斜向与直向的组合计算下界。
六、整理成算法
手算中的记录与常见代码中的名称一一对应:
| 名称 | 对应的记录或操作 |
|---|---|
g |
每个位置目前找到的最小到达代价 |
parent |
当前最佳路线中的前驱 |
OPEN |
等待处理的候选清单 |
| 扩展 | 检查一个位置的后续连接 |
| 松弛 | 计算经过当前位置的新路线,若更短就更新 |
1 | 把每个位置的 g 设为“尚未找到”,用 ∞ 表示 |
Dijkstra 取 ;A* 使用与地图运动规则相符的启发函数。
每个候选位置只保留一条当前有效记录:找到更小的 时同步更新优先级,即使该位置之前处理过,也允许重新加入。使用一致启发函数时,被正式取出的位置已经具有最短到达代价,不会再被严格更小的值更新。
实际代码常用优先队列维护 OPEN。如果采用“更新时再放入一条新记录”的写法,取出时要跳过已经过期的旧记录。
七、改一个数字再算一遍
把 S 到 B 的长度从 4 米改成 2 米,其他连接不变。
第一轮扩展 S 后,记录 A 为 1 米、B 为 2 米。第二轮扩展 A 时,经 A 到 B 的长度是 米,比已有的 2 米长,所以保留 B 的原记录和前驱 S。继续算下去,最短路线变为 S → B → C → G,总长 米。
每次都比较新旧累计距离,只有新路线更短时,才修改距离、前驱和优先级。
小结
Dijkstra 为每个位置记录当前最短的到达路线,每次扩展累计距离最小的候选。A* 使用同样的记录和更新机制,只是在排序时加上剩余距离的估计,让搜索朝目标方向集中。
手算任何一次搜索,都只需要追踪三件事:候选清单里有哪些位置,每个数字对应哪条路线,下一轮为什么选这个位置。最终路径再由前驱记录还原。