向量用来整理变量,矩阵用来表达变量之间的关系,二次型用来表达平方代价。理解这三件事,就能开始读懂许多约束、轨迹表示和优化模型。
本文重点是 Ax=b 的解与自由度,以及 x⊤Qx 的形状。矩阵乘法、内积和特征值围绕这两个问题展开;行列式等补充记号放在文末。具体怎样解方程,接着看矩阵分解。
1. 向量与矩阵:先看维度,再看含义
向量是排在一起的一组变量
例如位置和速度分别是三维向量,把它们放在一起就得到六维状态:
p=pxpypz∈R3,x=[pv]∈R6.
本文默认向量为列向量。x⊤ 表示转置,即把一列变成一行。
矩阵 A∈Rm×n 有 m 行、n 列。它乘以 n 维向量,得到 m 维向量:
m×nAn×1x=m×1Ax.
可以把它理解为:用 n 个输入,线性地计算 m 个输出。例如:
[2003][x1x2]=[2x13x2].
这个变换把第一个坐标方向拉长 2 倍,第二个方向拉长 3 倍。想象把一张方格纸横向、纵向分别拉伸,纸上的单位正方形就变成了长方形。
矩阵乘法也可以看成“沿各列方向移动”
把 A 的列记为 a1,…,an,则:
Ax=x1a1+⋯+xnan.
每一列提供一个方向,xi 决定沿该方向走多远;系数为负,就沿反方向走。将这些位移相加,便得到输出 Ax。
矩阵相乘表示连续做两次变换:ABx=A(Bx),右侧的 B 先作用,因此一般不能交换 A、B 的顺序。
转置时也要注意顺序:
(AB)⊤=B⊤A⊤.
例如 (Ax)⊤=x⊤A⊤。推导矩阵公式时,先检查乘法两侧的维度是否匹配,往往就能发现转置错误。
2. Ax=b:能否满足要求,还剩多少自由度?
列空间决定能否有解
线性方程组:
{x1+x2=3,2x1+x2=4⟺[1211][x1x2]=[34].
从列向量的角度,求解就是寻找系数 xi,让 x1a1+⋯+xnan=b。
所有列向量的线性组合组成 列空间:
Col(A)=span{a1,…,an}.
其中 span 表示这些方向通过任意数乘、相加所能到达的集合。因此:
Ax=b 有解⟺b∈Col(A).
两个共线的向量只能张成一条过原点的直线;两个不共线的向量可以张成一个平面。输出 b 如果在这个集合之外,就无法精确满足方程。
秩表示独立方向的数量
若某一列能由其他列线性组合得到,它就没有提供新方向,称为列向量之间存在 线性相关。矩阵的秩 rank(A) 就是独立列方向的数量,也等于独立行的数量。
例如:
A=[1224],rank(A)=1.
第二列是第一列的两倍,两个输入实际上只能控制一个输出方向。相应地,第二行方程也只是第一行的两倍。
一组既能张成空间、又没有冗余方向的向量称为一组 基,其中向量的个数就是空间的 维数。这里理解为“需要几个独立坐标才能描述这个空间”即可。
零空间表示不改变输出的方向
零空间定义为:
N(A)={d:Ad=0}.
如果 Ax0=b 已经成立,那么:
A(x0+d)=b+Ad.
所以,只要 d∈N(A),沿 d 改变变量就不会破坏原来的线性约束。
例如固定 x1+x2=3:
A=[11],x=[12]+t[1−1].
第一项增加 t,第二项减少 t,总和不变。(1,−1)⊤ 就是一个允许自由调整的方向。
对于有 n 列的矩阵:
dimN(A)=n−rank(A).
因此,在方程有解的前提下,满列秩意味着解唯一;秩小于 n 意味着还有自由变量。方程数量多,不等于独立约束多,重复的方程不会消除新的自由度。
对于方阵,满秩也等价于可逆,此时可写 x=A−1b。这是数学表达式;实际计算通常直接解方程,不先构造整个逆矩阵。
3. 内积、范数与投影
内积看方向,范数看长度
两个向量的内积为:
x⊤y=i∑xiyi=∥x∥2∥y∥2cosθ.
两个非零向量的内积为零,意味着它们互相垂直,即 正交。
二范数就是通常的欧氏长度:
∥x∥2=x⊤x,∥x∥22=x⊤x.
下标 2 表示二范数,右上角 2 表示平方。例如 x=(3,4)⊤ 的长度是 5,平方长度是 25。
投影是沿某个方向留下的分量
如果 q 是单位向量,那么 q⊤x 是 x 沿 q 的有符号投影长度,对应的投影向量为:
projq(x)=(q⊤x)q.
例如 q=(1,0)⊤,x=(3,4)⊤,投影为 (3,0)⊤;剩下的 (0,4)⊤ 与 q 垂直。这个“投影加垂直残差”的关系,是理解最小二乘的基础。
若一个方阵 U 的列都是单位向量且两两正交,则:
U⊤U=I,U−1=U⊤,∥Ux∥2=∥x∥2.
这样的 正交矩阵 可以旋转或反射向量,但保持长度不变。后面的特征分解以及 QR、SVD 都会用到它。
4. 二次型:把平方代价写成矩阵形式
二次型表达不同方向的权重
形如 x⊤Qx 的标量表达式称为二次型。二维时:
Q=[abbc]⟹x⊤Qx=ax12+2bx1x2+cx22.
对角元素控制各变量平方项的权重,非对角元素产生变量之间的交叉项。
例如 Q=diag(1,4) 时,代价为 x12+4x22。同样偏离 1 个单位,第二个方向的代价是第一个方向的 4 倍。Q=I 时,就退化为普通的平方长度 ∥x∥22。
本文讨论二次型时采用实对称矩阵 Q=Q⊤。这并不损失一般性,因为任意实方阵都有:
x⊤Ax=x⊤(2A+A⊤)x.
也就是说,二次型只取决于矩阵的对称部分。
平方误差为什么也是二次型?
设残差为 Ax−b,则:
∥Ax−b∥22=(Ax−b)⊤(Ax−b)=x⊤A⊤Ax−x⊤A⊤b−b⊤Ax+b⊤b=x⊤A⊤Ax−2b⊤Ax+b⊤b.
中间两项相等,因为它们是互为转置的标量。二次项的矩阵就是 Q=A⊤A。
如果 Ax=b 无法精确满足,最小化这个平方误差,就是在列空间中找离 b 最近的点;最优残差与列空间正交。它可能投影到一条直线,也可能投影到一个平面或更高维子空间。
5. 特征值与正定性:代价像碗、槽还是鞍面?
特征向量是变换中的特殊方向
若非零向量 v 满足:
Qv=λv,
那么 v 是特征向量,λ 是对应的特征值。对实特征向量而言,变换后的向量仍在原来的直线上:λ>0 时按比例缩放,λ<0 时还会翻转方向,λ=0 时被压到原点。
实对称矩阵可以选取一组单位正交特征向量,组成 U:
Q=UΛU⊤,Λ=diag(λ1,…,λn).
令 z=U⊤x,相当于换成沿特征方向的坐标,于是:
x⊤Qx=z⊤Λz=i∑λizi2.
这一步解释了为什么特征值能判断二次型的形状:换一套正交坐标后,交叉项消失,每个方向只剩一个平方项及其权重。
正定和半正定的区别
下面都针对实对称矩阵 Q:
| 性质 |
二次型条件 |
特征值条件 |
直观形状 |
| 正定 Q≻0 |
对所有 x=0,x⊤Qx>0 |
全部为正 |
严格向上的碗 |
| 半正定 Q⪰0 |
对所有 x,x⊤Qx≥0 |
全部非负 |
可以有平坦方向 |
| 不定 |
在不同方向既取正值又取负值 |
既有正值又有负值 |
鞍面 |
正定也属于半正定;只有出现零特征值时,半正定二次型才有非零的平坦方向。
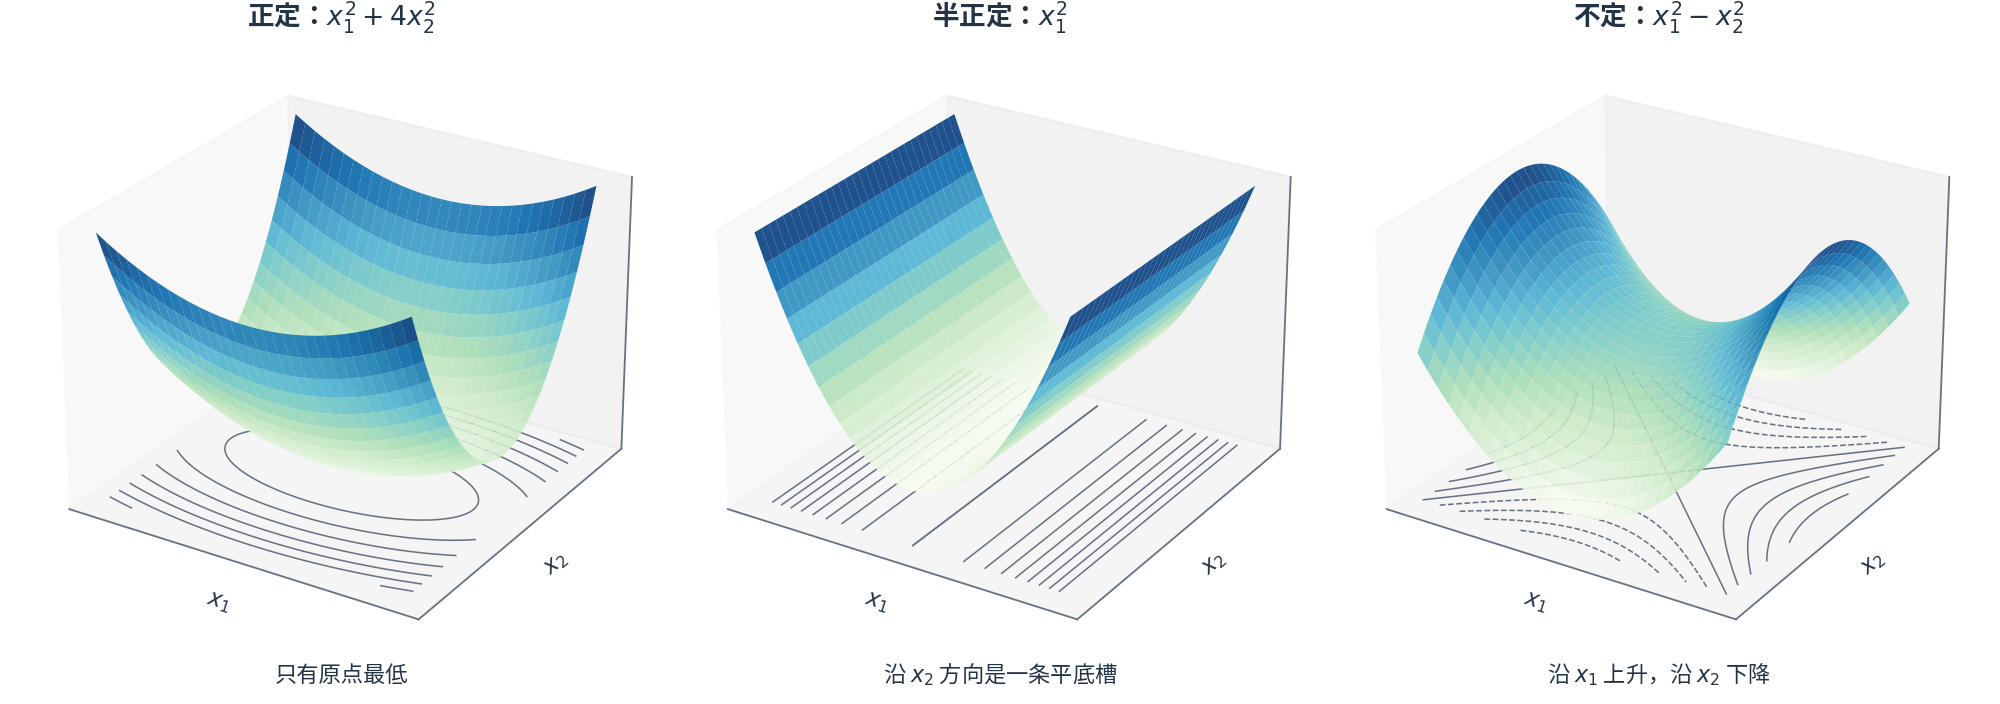
三个例子分别是:
x12+4x22,x12,x12−x22.
第一个只有原点最低;第二个像一条槽,沿 x2 方向移动不改变代价;第三个沿 x1 方向上升、沿 x2 方向下降。
平方误差中的 A⊤A 一定半正定,因为:
x⊤A⊤Ax=∥Ax∥22≥0.
它正定当且仅当 A 满列秩:这时任何非零输入都不会被 A 压到零,平方代价也就没有非零的平坦方向。
6. 二次目标与线性约束放在一起
无约束时,最优点来自一个线性系统
考虑 Q=Q⊤ 时的二次函数:
f(x)=21x⊤Qx+c⊤x.
它的梯度和 Hessian 分别为:
∇f=Qx+c,∇2f=Q.
梯度描述一阶变化,Hessian 描述二阶变化,具体求导见多元微积分。
Q⪰0 时函数凸;Q≻0 时函数严格凸,且这个无约束二次问题有唯一最优点,满足:
Qx=−c.
如果 Q 只是半正定,最优解可能不唯一,也可能不存在。例如 f(x1,x2)=x12+x2 可以沿负 x2 方向无限下降。
有约束时,只需考察允许移动的方向
常见模型为:
xmin 21x⊤Qx+c⊤x,Ax=b.
假设约束可行,取一个解 x0,并将 N(A) 的一组基排成矩阵 N。全部可行变量都能写为:
x=x0+Nz.
这里 z 才是可以自由调整的变量。代入目标后,关于 z 的二次项是:
21z⊤N⊤QNz.
即使 Q 在整个空间里只是半正定,只要它在剩余自由方向上严格为正,约束也能使最优解唯一。
例如 f(x1,x2)=x12 原本有一整条最低线;加上约束 x2=0 后,唯一最优点就是 (0,0)。因此,判断唯一性时需要把代价与约束一起看。
固定时间的多项式平滑代价和边界条件常具有这种结构:系数决定函数形状,线性约束固定端点与连续性,二次目标在剩余自由度中选择较平滑的结果。
7. 稀疏结构:一个变量通常只影响附近几个变量
如果每个关系只涉及相邻变量,矩阵就会有大量零元素。例如:
A=2100121001210012.
可以把离散轨迹想象成一串相连的点:每个约束只联系附近几个点,对应矩阵的每一行就只有少数非零项。
这里首先要能看出哪些变量互相影响。保留这种结构,才能在存储和求解时使用稀疏或带状方法;具体算法放到矩阵分解一篇讨论。
8. 核心关系速查
| 想知道什么 |
对应关系 |
| 矩阵怎样组合输入 |
Ax=∑ixiai |
| 方程是否有解 |
b∈Col(A) |
| 哪些变化不破坏线性约束 |
Ad=0 |
| 还剩几个自由变量 |
n−rank(A) |
| 怎样表达平方误差 |
∥x∥22=x⊤x |
| 二次代价有哪些主要方向 |
Qv=λv |
| 二次代价是否非负 |
实对称 Q⪰0 |
| 约束下的二次项 |
N⊤QN,其中 N 为零空间基矩阵 |
补充:遇到时再查的记号
- 子空间:对相加和数乘封闭、且包含零向量的集合。列空间和零空间都是子空间;Ax=b 在 b=0 且有解时通常是一个平移后的集合,不是向量子空间。
- 行列式:对方阵,det(A)=0 等价于可逆。特征值满足 det(A−λI)=0;理解这个关系即可,实际大矩阵的特征值通常交给数值算法计算。
- 旋转矩阵:三维旋转满足 R⊤R=I、detR=1,即保持长度与方向取向的正交变换。
这些记号有助于读公式,首次学习不必展开行列式计算技巧、抽象子空间证明或完整的特征值求解算法。